
Ну вот и первые ласточки RSI: Исследователи Google и DeepMind…
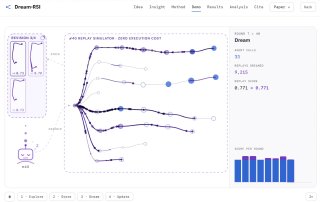
Ну вот и первые ласточки RSI: Исследователи Google и DeepMind представили работу о самоулучшении ИИ через собственный опыт. Исследователи Google, DeepMind и университетов Мэриленда и Вирджинии выкатили Dream-RSI. Система сохраняет историю экспериментов и переигрывает её с разными стратегиями: какие идеи развивать, какие тупики раньше бросить, что проверять параллельно. Лучшую стратегию применяют в следующем настоящем запуске, получают новый опыт и повторяют цикл. ИИ совершенствует способ поиска решений, не переобучая саму нейросеть.
В разработке алгоритмов авторы получили до 162 раз меньше вызовов агента относительно SimpleTES, хотя системы использовали разные базовые модели. При сравнении на одной модели выигрыш составил около 1,7 раза, с улучшением результата. В отдельных задачах оптимизации GPU-кода потребовалось до 2,43 раза меньше генераций. Если подход масштабируется, он может ускорить и разработку самого ИИ: больше полезных экспериментов за те же деньги. Пока это улучшение исследовательской стратегии, но вполне конкретный шаг к агентам, которые сами совершенствуют свою работу. Статья и примеры открыты, полный код ещё готовят к публикации.
Похожие записи
Оцените материал:
Похожие записи
Viggle Mine меняет персонажа в видео и не теряет его…
17.09.2026
SmartSave наводит порядок в output ComfyUI с помощью Ollama Появилась…
17.09.2026
Minecraft впервые устроил ИИ настоящий игровой тильт: GPT-6 Astra после…
17.09.2026Присоединяйтесь и подпишитесь на рассылку самых свежих новостей по Email
Получайте свежие новости и идеи на почту. Без спама — только самое интересное.
Нажимая «Подписаться», вы соглашаетесь с политикой конфиденциальности.