Вышла ElevenLabs v4: как озвучить текст на русском с эмоциями
Я делаю ролики нейросетями и прогнал новую ElevenLabs v4 на русском во всех режимах: озвучка, эмоции, диалог двух голосов, смена голоса и перевод записи. Внутри примеры, куда нажимать в боте и что делать с ударениями. Подскажите, какой режим вам нужнее всего?
Голос нейросети обычно выдаёт себя ровной интонацией: всё звучит одинаково бодро, хоть реклама, хоть грустная история. В новой ElevenLabs v4 подачу задают прямо в тексте. Пишете перед фразой слово в квадратных скобках, например [whispers], и эту фразу модель произносит шёпотом, а само слово вслух не звучит.
Я делаю ролики и картинки нейросетями и проверяю модели на своих задачах. ElevenLabs v4 вышла 28 сентября, и я прогнал её на русском во всех режимах: озвучка одним голосом, эмоции, диалог двух голосов, смена голоса, перевод записи. Всё делал в боте Cyber AI: ElevenLabs там лежит в разделе «Аудио», а до 12 октября на озвучку v4 действует скидка 50%.
Что умеет ElevenLabs v4
ElevenLabs превращает текст в речь. Вставляете текст, выбираете голос и получаете аудиофайл, который кладёте на ролик, в рекламу, сторис или подкаст.
Четвёртая версия отличается тремя вещами:
• эмоции и подача задаются словами в квадратных скобках: смех, шёпот, вздох, пауза;
• в диалоге несколько голосов разговаривают друг с другом в одном файле, по очереди;
• языков стало больше: в списке бота у v4 их 86, русский среди них. Полный список и ограничения модели есть в документации ElevenLabs.
В той же карточке есть ещё три режима: смена голоса на готовой записи, перевод с переозвучкой на другой язык и создание своего голоса. Разберу каждый на примерах.
Где найти ElevenLabs в боте
Открываете бота и жмёте «🚀 Открыть приложение». На главном экране кнопка «🎵 Аудио», дальше раздел «Музыка и Озвучка» и карточка «🗣 Elevenlabs».
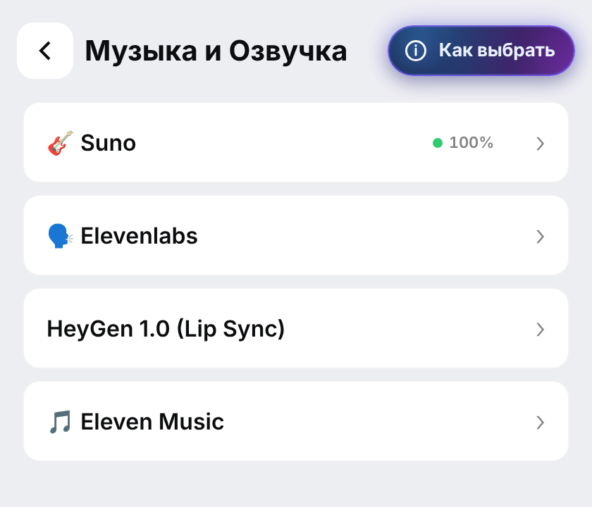
Наверху карточки поле «Режим». От него зависит, что будет ниже: «Озвучка диалога», «Смена голоса» или «Дублирование». Баннер со скидкой видно только в режиме озвучки: на смену голоса и перевод она не действует.
Озвучка текста на русском одним голосом
С этого режима стоит начать. По шагам:
1. «Режим» — «Озвучка диалога». Название сбивает, но с одной репликой это обычная озвучка текста.
2. «Версия модели» — «v4, новая».
3. «Стабильность голоса» — для начала «Сбалансированный».
4. «Язык» — «Русский». Подсказка в боте советует ставить язык того текста, который озвучиваете.
5. В блоке «Диалог» жмёте на поле голоса, выбираете голос и вставляете текст в поле реплики.
6. Жмёте «Сохранить», готовый файл приходит в чат с ботом.
Голоса в библиотеке разложены по папкам: дикторы, разговорные, эпические, для историй, популярные в TikTok и другие. Перед выбором голос можно послушать. Названия у голосов английские, но русский текст они читают по-русски.
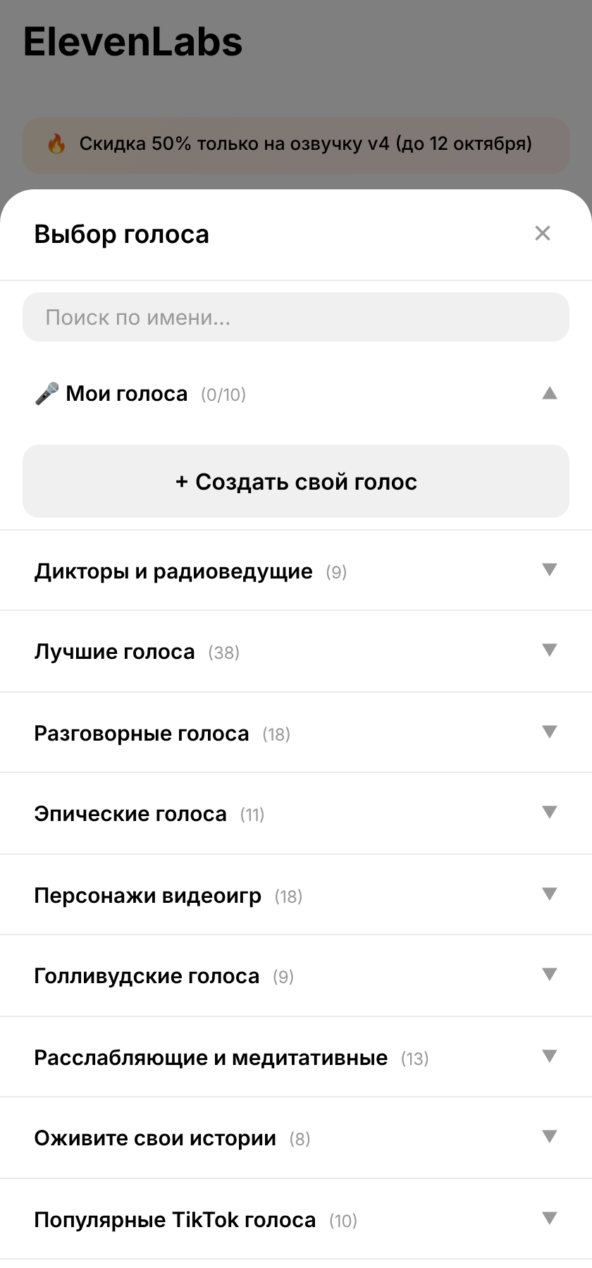
Вот рекламный текст для кофейни. Голос Brian из папки «Популярные TikTok голоса», текст вставил как есть, с цифрами:
Маленькая кофейня на углу Садовой открылась в 2019 году. С тех пор здесь почти ничего не изменилось: тот же запах свежей обжарки, те же деревянные столы и бариста, который помнит, какой кофе вы пьёте. С 12 октября по будням с восьми до десяти утра второй капучино — за полцены. Заходите, мы вас ждём.
Год, дату и время модель прочитала правильно, переписывать числа словами не пришлось. Повторить можно в том же боте с этими настройками.
Про «Стабильность голоса». «Динамичный» даёт больше эмоций, но каждая генерация звучит немного по-своему. «Стабильный» читает ровнее и одинаковее, это для длинных дикторских текстов. «Сбалансированный» посередине. В одну генерацию влезает до 5000 знаков, длинный текст делите на части.
Озвучка текста с эмоциями: теги в квадратных скобках
Тег — это слово-подсказка в квадратных скобках перед фразой. Модель не читает его вслух, а меняет подачу. По правилам ElevenLabs тег действует на текст после него, пока не встретится следующий.
Начать удобно с этих: [laughs] — смех, [whispers] — шёпот, [sighs] — вздох, [excited] — радостное волнение, [thoughtful] — задумчиво, [pause] — пауза, [shouts] — крик.
Вот короткая история с шестью тегами. Голос Jessica, «Стабильность голоса» — «Динамичный», чтобы эмоции звучали ярче:
[excited] Слушайте, что сегодня было! [laughs] Я полгода копила на новый телефон… [sighs] и утром уронила его прямо в лужу. [whispers] Только маме не говорите. [pause] [thoughtful] Хотя знаете… он даже не намок. Чехол оказался лучше, чем обещали.
Ни один тег не прозвучал вслух, а фраза про маму сказана шёпотом, заметно тише остального текста. Вот ради этого и стоит переходить на v4.
Писать теги по-английски не обязательно. Тот же текст с тегами [радостно], [смеётся], [вздыхает], [шёпотом], [пауза], [задумчиво] модель тоже не прочитала вслух, и шёпот на месте:
Правила из гайда ElevenLabs:
• одна эмоция на фразу: три тега на одно короткое предложение сбивают подачу;
• голос важнее тега: спокойного диктора трудно заставить кричать, а бодрого блогера — шептать;
• пунктуация тоже управляет голосом: многоточие даёт паузу, восклицательный знак — напор;
• если подача не понравилась, сначала замените тег на соседний по смыслу и только потом переписывайте текст.
Как поставить ударение в ElevenLabs
Главный страх с русской озвучкой — ударения: омографов-то в языке полно. Я проверил самые коварные из них, замок на холме и замок на калитке, одним предложением.
Утром мы осмотрели старинный замок на холме, а вечером купили новый замок для калитки. Ключ от замка я потерял в тот же день.
Здесь v4 расставила ударения по смыслу: зАмок на холме, замОк для калитки, ключ от замкА. Но короткой фразе без подсказок модель может и ошибиться. Если слово прочиталось не так, есть два способа помочь.
• Добавить контекст. Не «новый замок», а «новый дверной замок»: так слово уже не спутать.
• Поставить знак ударения над гласной: замок, замок. Скопируйте нужную букву отсюда и вставьте вместо обычной: а, о, у, е, и, ы, э, ю, я.
Со знаками ударения модель прочитала ту же фразу правильно и на значках не споткнулась:
Заглавную букву вместо ударения, вроде «зАмок», я бы не ставил. В ElevenLabs заглавными выделяют слово голосом, и модель может произнести его громче.
Диалог двух голосов
Режим для сценок, рилс и подкастов. В той же «Озвучке диалога» жмёте «+ Добавить реплику», и у каждой реплики свой голос и свои теги. Модель озвучивает всё одним файлом, голоса говорят по очереди.
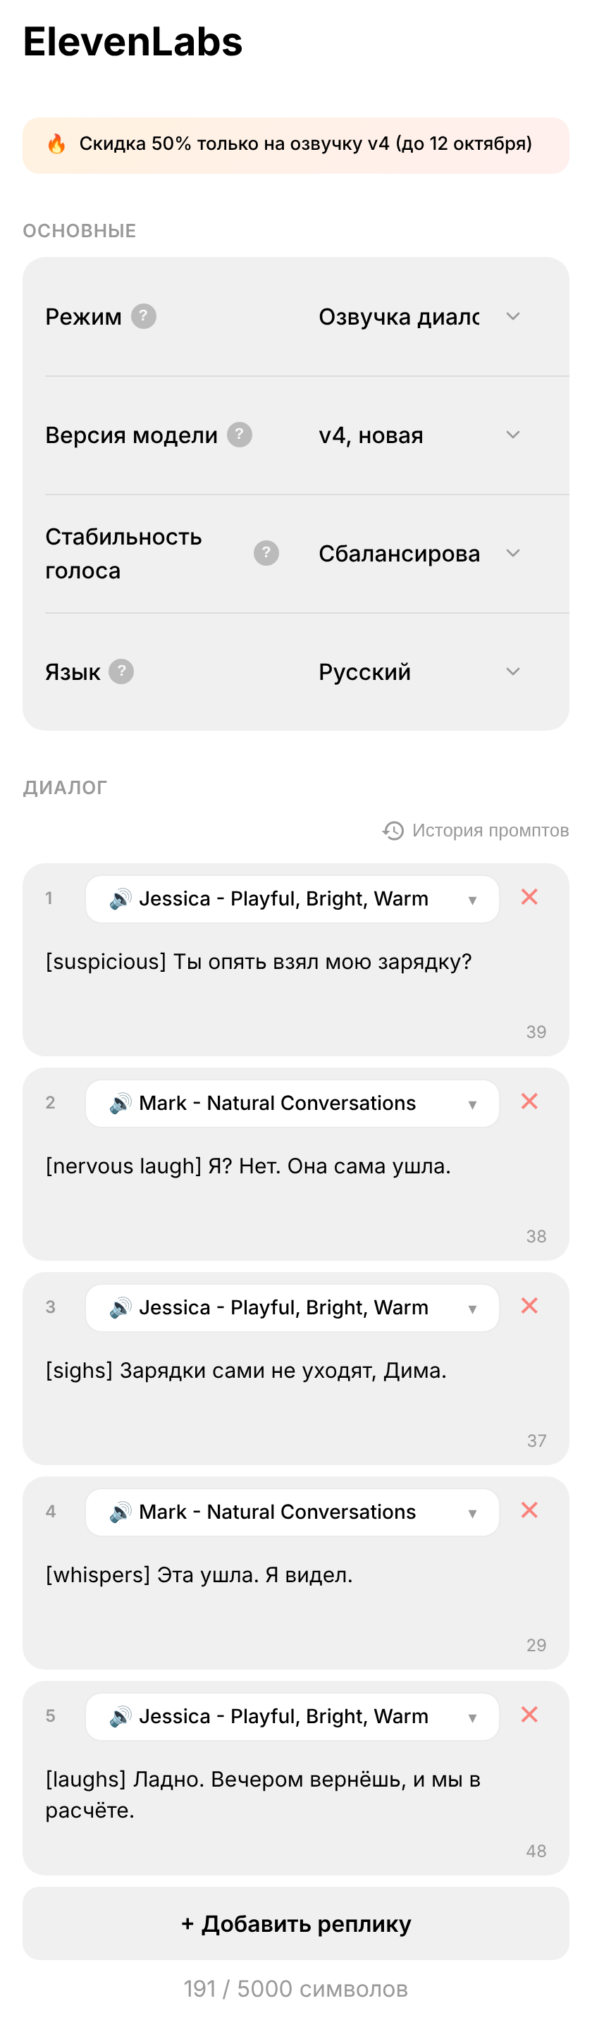
Моя сценка про зарядку: Jessica и Mark из папки «Популярные TikTok голоса», пять реплик, теги [suspicious], [nervous laugh], [sighs], [whispers], [laughs].
Берите для персонажей голоса с разным тембром, иначе на слух их трудно различить. Реплик в одном файле может быть до 20.
Смена голоса на готовой записи
Этот режим не читает текст, а переделывает готовую запись. Загружаете аудио или видео со своей речью, выбираете голос из библиотеки и получаете ту же речь, с теми же паузами и интонациями, но другим тембром. Пригодится, если свой голос в ролике не нравится или нужен женский голос вместо мужского.
1. «Режим» — «Смена голоса».
2. В блоке «Исходный файл» жмёте «Выбрать» и загружаете аудио или видео длиной до 5 минут.
3. В блоке «Голос» выбираете новый голос.
4. Жмёте «Сохранить». Если загружали видео, вернётся то же видео с новым голосом.
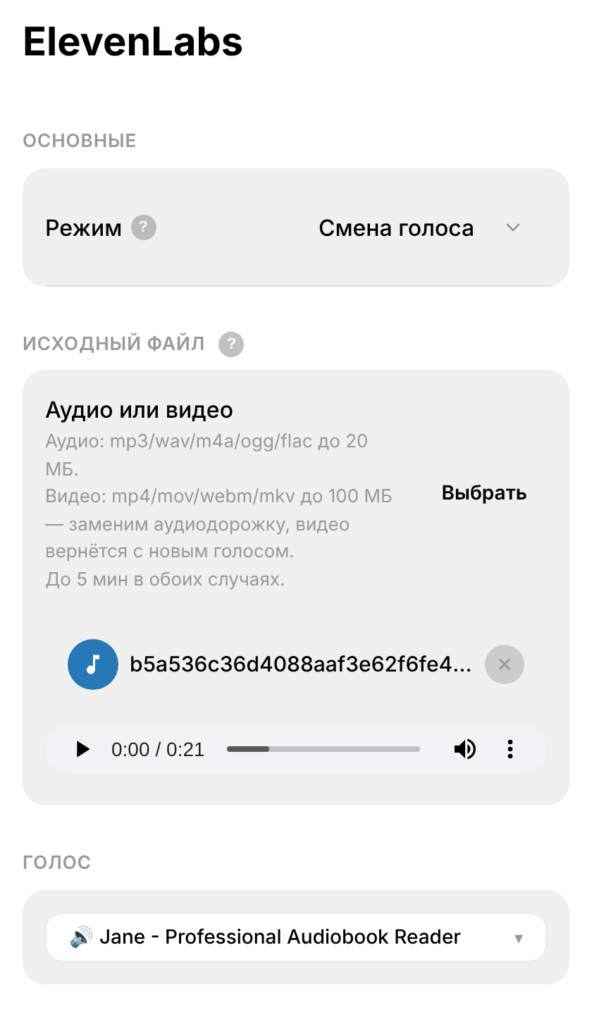
Я взял озвучку кофейни из начала статьи и переделал её голосом Jane из папки «Лучшие голоса»:
Слова, паузы и темп остались прежними, поменялся только голос. Версии модели у этого режима нет, поле появляется только в озвучке.
Перевод записи на другой язык
Режим «Дублирование» переводит запись на другой язык и сразу её озвучивает. Подходит для интервью, лекций и роликов для зарубежной аудитории.
1. «Режим» — «Дублирование».
2. «Версия дубляжа» — v1 или v2. Подсказка в боте объясняет разницу: v1 работает давно и стабильно, v2 переводит точнее и знает диалекты, но ElevenLabs пока называет её альфа-версией.
3. В «Исходный файл» загружаете аудио или видео, до 30 минут.
4. «Язык оригинала» можно оставить «Авто», в «Язык дубляжа» выбираете нужный.
5. «Число спикеров» — сколько человек говорит в записи, ноль значит определить автоматически. «Убрать фоновую дорожку» вырезает музыку: для лекции подходит, для клипа нет.
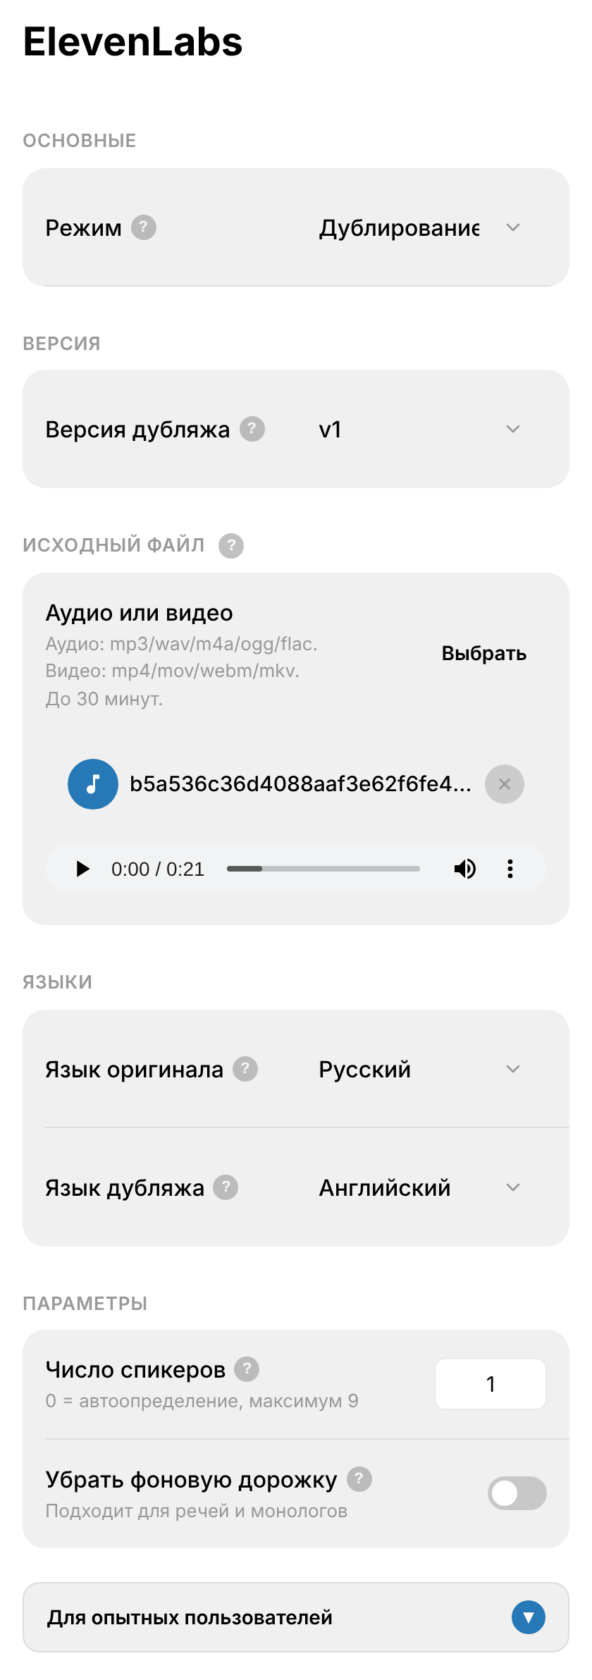
Та же реклама кофейни, переведённая на английский в версии v1:
Перевод вышел точным: улица стала Sadovaya, «за полцены» — half price, дату и время модель прочитала уже по-английски. По умолчанию ElevenLabs копирует тембр исходного голоса, чтобы на новом языке он звучал похоже. Если запись шумная, это отключается в «Для опытных пользователей» — «Не клонировать голос».
Как создать свой голос
Здесь без примера: для клона нужна живая запись человека и его согласие. Порядок такой:
1. В режиме «Озвучка диалога» жмёте на поле голоса у любой реплики.
2. В окне «Выбор голоса» первая строка — «Мои голоса», под ней кнопка «+ Создать свой голос».
3. Пишете название голоса, описание по желанию.
4. Через «+ Добавить файл» загружаете записи. Можно несколько файлов, если на всех один и тот же человек.
5. Если на записи слышен шум, ставите галочку «Удалить фоновый шум». Подсказка предупреждает: фильтр иногда съедает части голоса.
6. Жмёте «Создать» и подтверждаете согласие на работу с голосом.
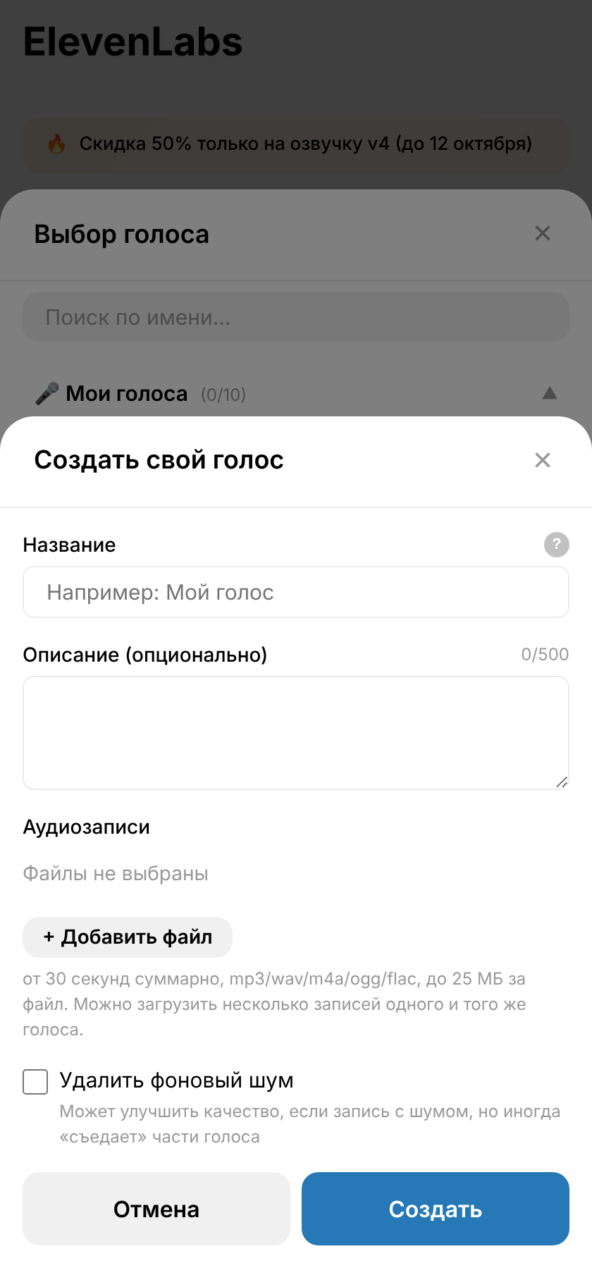
Требования к записи бот подсказывает сам:
• в записи говорит один человек;
• на фоне нет музыки и шума;
• все файлы записаны на один микрофон в одной обстановке;
• в сумме не меньше 30 секунд, лучше 1-3 минуты.
Готовый голос появится в «Моих голосах». Им можно озвучивать любой текст или подставлять его в свои записи через «Смену голоса». Своих голосов на аккаунт можно сделать до десяти. Клонировать чужой голос без разрешения его владельца нельзя: это запрещают правила ElevenLabs.
Какой режим взять под задачу
• Текст для рекламы, ролика или сторис — «Озвучка диалога» с одной репликой.
• История с эмоциями — тот же режим, плюс теги и «Динамичный».
• Сценка на двоих — «Озвучка диалога», реплики разными голосами.
• Есть запись, но нужен другой голос — «Смена голоса».
• Ролик нужен на другом языке — «Дублирование».
• Хочется озвучивать своим голосом, не записывая каждый текст, — сначала «Свой голос», потом озвучка им.
Всё из статьи я делал в боте, где ElevenLabs лежит рядом с моделями для видео, так что озвучку можно сразу положить на ролик: Telegram | MAX.
А вам озвучка нужна для чего: ролики, реклама или подкасты?
#нейросети #elevenlabs #озвучка #синтезречи
Источник: vc.ru
Оцените материал: