Train и eval в ARC-AGI-2 — это разные распределения

Если вы замеряете прогресс своего солвера на случайной подвыборке из train, вы замеряете его не на том наборе. Медианная задача train занимает 100 клеток на выходе, у медианной задачи eval их 225. Два и более тестовых входа требуют 6.9 процента задач train и 40.8 процента задач eval. Расхождение держится по всем шести структурным осям, которые я померил, и переживает поправку на множественные сравнения.
Дальше идёт распределительное сравнение обоих публичных наборов ARC-AGI-2, отпечатки файлов, на которых оно сделано, и подмножество из train, подобранное под eval по структуре. CSV со списком задач в конце.
Сразу оговорка, к которой я вернусь отдельным разделом: всё это про структуру, а не про сложность для человека. Свой же индекс я проверил против человеческих решений, и он проверку не прошёл.
Что показали измерения
Источник: habr.com
Оцените материал:
Похожие записи
Signal ограничивает возможность делать скриншоты на мобильных устройствах, поскольку сталкивается с «экзистенциальной угрозой» слежки со стороны искусственного интеллекта.
22.11.2026
Конец кислотным градиентам и эмодзи. Скилл unslop-ui вычищает ИИ-мусор из вайбкодинга
22.11.2026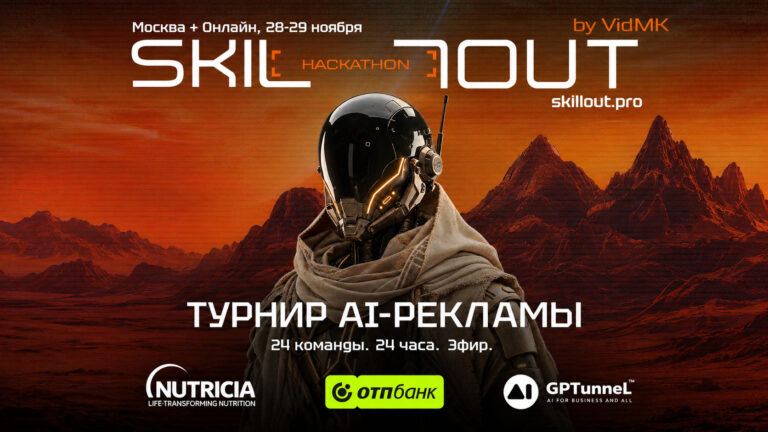
GPTunneL и SKILLOUT проведут хакатон ИИ‑рекламы в Москве 28–29 ноября. Открыта регистрация для онлайн‑участников
22.11.2026Присоединяйтесь и подпишитесь на рассылку самых свежих новостей по Email
Получайте свежие новости и идеи на почту. Без спама — только самое интересное.
Нажимая «Подписаться», вы соглашаетесь с политикой конфиденциальности.