Преодоление узких мест в процессе вывода: ускорение сложного поиска в ИИ с помощью функции Retrieve-for-Train.
Вместо того чтобы полагаться на дорогостоящие вычисления на этапе вывода, фреймворк Retrieve-for-Train использует обучение с подкреплением один раз для обучения легковесной модели распространения. Это позволяет обойти ресурсоемкий авторегрессивный «бюджет мышления» и мгновенно сгенерировать целостный набор результатов поиска на экспертном уровне.
Быстрые ссылки
- Бумага
- Делиться
Современные приложения для поиска и рекомендаций все чаще ожидают от пользователей выдачи согласованного набора результатов, а не одного наилучшего совпадения. Например, когда пользователь ищет «снаряжение для кемпинга», он не хочет видеть десять незначительно отличающихся друг от друга вариантов четырехместных палаток. Ему нужен согласованный, взаимодополняющий набор, включающий необходимое снаряжение для кемпинга, такое как палатка, спальный мешок, портативная плита и налобный фонарь.
Для этого системы используют метод разветвления запросов, который разбивает один общий запрос на несколько связанных подзапросов для охвата потенциальных интересов пользователя. Однако обучение LLM динамическому разложению запросов с учетом базы данных требует огромных вычислительных ресурсов. По своей сути, LLM с нулевым количеством примеров являются общими авторегрессивными предикторами текста; они не оптимизированы для навигации по специфическому геометрическому многообразию целевого корпуса. Следовательно, им требуется длительное время вычислений для получения набора результатов, оптимизирующих свойства более высокого порядка на уровне множества (например, разнообразие, охват, комплементарность, согласованность), оставаясь при этом привязанными к фиксированной базе данных.
В нашей статье «Эффективное, согласованное со свойствами распределение вероятностей с помощью диффузии, компилируемой с помощью обучения с подкреплением» на конференции ICML 2026 мы решаем эту проблему декомпозиции с помощью структуры компиляции вознаграждения в данные. Вместо того чтобы заставлять модель тратить большой бюджет на мышление на этапе вывода, наша структура Retrieve-for-Train использует автономное обучение с подкреплением (RL) для обнаружения распределений вероятностей, согласованных с вознаграждением, и их компиляции в обучающую выборку. Сводя эти оптимизированные модели исследования к легковесному механизму диффузионного поиска, мы обеспечиваем высокоэффективное, однопроходное распределение вероятностей запросов на этапе вывода. Это позволяет получить математически сформулированные свойства на уровне множества без дополнительных затрат на токены мышления на этапе тестирования.
Почему обычный ИИ не является экспертом по поиску
При решении задачи по генерации сложной группы поисковых запросов возникает соблазн просто использовать стандартную, готовую модель LLM на этапе вывода. Однако использование универсальных моделей для декомпозиции запросов с учетом особенностей базы данных создает две серьезные проблемы:
- Парафрастическое схлопывание : Без оптимизации с учетом особенностей базы данных, LLM-ы с нулевым количеством примеров часто страдают от парафрастического схлопывания. Вместо того чтобы исследовать взаимодополняющие аспекты темы, они, как правило, генерируют избыточные, почти синонимичные запросы. Например, при наличии общего запроса «Богемный фестивальный стиль» стандартный LLM-шаблон без тщательной проработки запроса может лениво сгенерировать запросы «богемная фестивальная мода» и «богемная фестивальная одежда». Это семантическое зацикливание приводит к однородному набору результатов, полностью упуская из виду четкие, полезные семантические направления, которые мог бы определить эксперт по моде, такие как куртки с бахромой, вязаные платья или замшевые сапоги.
- Авторегрессивные узкие места задержки : Стандартные модели LLM принципиально ограничены последовательной авторегрессивной генерацией. Для успешного разложения сложного запроса на взаимодополняющие аспекты современным моделям обычно требуется значительный бюджет на мышление, генерирующий сотни промежуточных токенов цепочки рассуждений (т. е. промежуточных шагов или внутренних блоков обработки, которые модель ИИ генерирует перед ответом на сложный вопрос), чтобы спланировать их расширение перед выводом фактических поисковых запросов. Хотя такое целенаправленное рассуждение приемлемо для разговорного ИИ, оно создает серьезное структурное узкое место для поиска по множеству значений (например, получение взаимодополняющего набора результатов, таких как куртки с бахромой или вязаные платья, упомянутые выше). Когда система должна одновременно обрабатывать большой набор подзапросов, совокупные накладные расходы на непрерывную обработку контекста и генерацию расширенных токенов рассуждений масштабируются плохо. Даже при использовании передовых методов оптимизации обработки запросов, такая архитектура, основанная на обработке каждого токена отдельно, создает минимальный уровень задержки, который принципиально противоречит требуемому времени отклика менее секунды для поисковой строки в реальных условиях.
Структура Retrieve-for-Train
Retrieve-for-Train рассматривает обучение ИИ как офлайн-тренировку, а не как тест, который нужно пройти на месте, пока пользователь ждет. Вместо того чтобы заставлять ИИ медленно выяснять правила хорошего поиска и расходовать огромные вычислительные ресурсы каждый раз, когда кто-то вводит запрос, Retrieve-for-Train запускает программу обучения с подкреплением в автономном режиме всего один раз.
Эта программа использует строгую систему вознаграждения, чтобы превратить абстрактные цели, такие как «обеспечить разнообразие результатов и наличие товара на складе», в точную пошаговую инструкцию. После создания такой инструкции ИИ может мгновенно выполнить ее во время реального поиска без задержек.
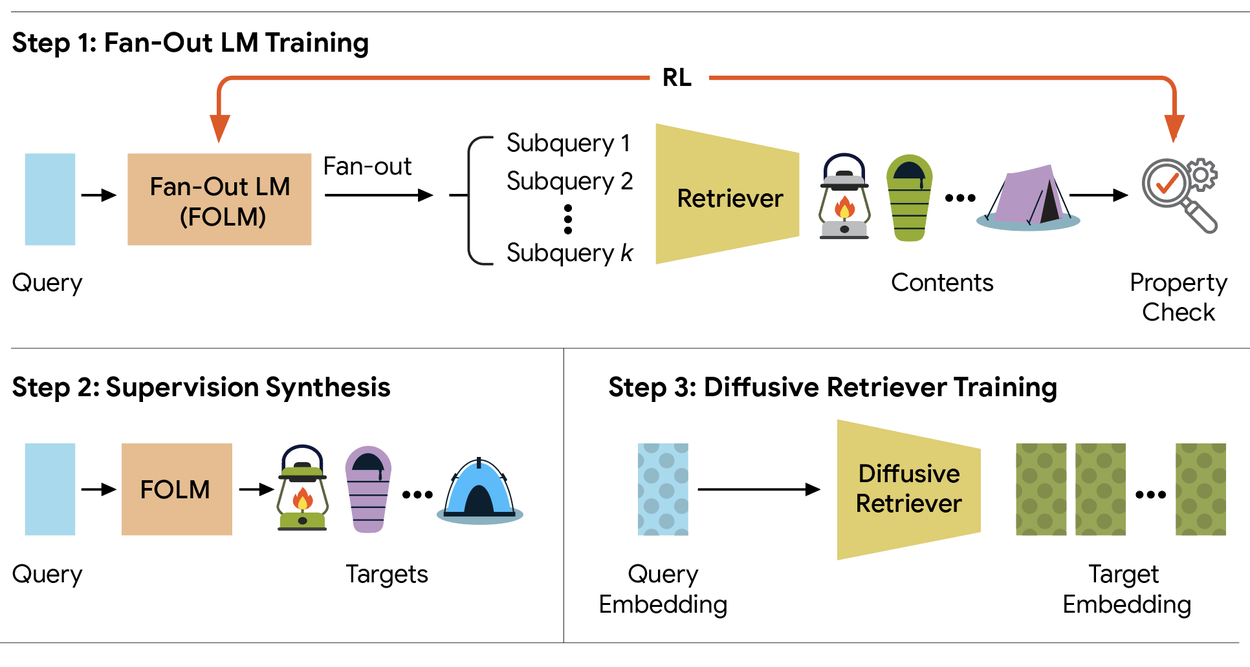
Конвейерная система работает в три отдельных этапа:
- Обучение языковой модели с использованием метода «расширенного поиска»: в рамках обучения с подкреплением языковая модель с использованием метода «расширенного поиска» обучается генерировать подзапросы, выровненные по свойствам и оцениваемые с помощью вознаграждения за проверку свойств на уровне множества. Это позволяет оценить всю группу результатов в целом, а не каждый результат по отдельности.
- Синтез с учителем: Замороженная языковая модель с разветвлением синтезирует пары (запрос → целевой набор) полностью в автономном режиме для обучения с учителем, не требуя разметки человеком.
- Обучение диффузионного ретривера: компактная диффузионная модель с 53,9 млн параметров учится напрямую сопоставлять векторное представление запроса с полным набором векторных представлений цели за один проход без авторегрессии, официально обходя необходимость в текстовых токенах для рассуждений CoT.
Обзор структуры Retrieve-for-Train. Шаг 1: обучает языковую модель с разветвленным представлением (FOLM) с использованием обучения с подкреплением для создания подзапросов, выровненных по свойствам. Шаг 2: использует обученную FOLM для синтеза данных для обучения с подсказками. Шаг 3: обучает ретривер с разветвленным представлением на основе диффузии, который непосредственно выбирает векторные представления контента из векторных представлений запросов.
Разработка дизайна для целевой аудитории: сила составных вознаграждений
Успех подхода Retrieve-for-Train полностью зависит от того, как мы определяем «хорошее» поведение при поиске. Традиционное обучение с учителем оценивает точечную релевантность, обучаясь ранжированию и оценивая каждый найденный элемент по отдельности. Однако по-настоящему экспертный поисковый набор определяется неразложимыми свойствами на уровне множества. Невозможно измерить разнообразие или взаимодополняемость отдельного элемента; эти свойства существуют математически только при оценке всей совокупности найденных результатов.
Вместо того чтобы полагаться на неоднозначные инструкции на естественном языке для обеспечения этих свойств распределения, Retrieve-for-Train дорабатывает языковые модели с открытым исходным кодом 4B (Gemma3-4B и Qwen3-4B) с помощью обучения с подкреплением, используя строгое математическое составное вознаграждение. Для наших задач поиска абстрактных понятий с открытым концом это составное вознаграждение представляет собой взвешенный баланс трех конкурирующих составляющих:
- Принцип обоснованности: Наказывает за расстояние до многообразия базы данных, гарантируя, что каждый сгенерированный подзапрос соответствует реальному, извлекаемому элементу в базе данных.
- Разнообразие: Измеряется с помощью показателя Vendi Score по всему набору подзапросов, что заставляет модель исследовать широкий семантический диапазон.
- Выравнивание: Привязывает потенциальные подзапросы к исходному общему запросу, чтобы предотвратить семантическое смещение.
Взаимные контр-якоря и мягкое обучение GRPO
В процессе обучения мы оптимизируем языковую модель с разветвленной структурой, учитывая эти геометрические особенности, используя групповую относительную оптимизацию политики (GRPO) с мягкой проксимальной оптимизацией политики (PPO).
Эта конкретная триада вознаграждений имеет решающее значение, поскольку они действуют как взаимные контр-якоря. Если модель оптимизирована исключительно для обеспечения обоснованности, она будет использовать систему «взлома вознаграждений», генерируя вырожденные, бессмысленные строки, которые математически соответствуют определенной координате в базе данных. Если добавить выравнивание для исправления бессмысленности, политика просто обманет систему, превратившись в повторяющиеся перефразировки запроса пользователя.
Внедряя показатель Венди в качестве контр-якоря, алгоритм Retrieve-for-Train эффективно блокирует подобные упрощенные решения. Для достижения состояния с высокой отдачей, алгоритм вынужден находиться в сбалансированной области пространства встраивания, где он должен обнаружить допустимые, строго обоснованные, но семантически отличающиеся варианты исходного намерения.
Эксперименты
Для оценки структуры Retrieve-for-Train мы использовали комбинацию замороженных, специфичных для набора данных многомодальных баз данных для встраивания и языковых моделей с открытым исходным кодом, оптимизированных для расширения запросов. Мы оценили эту конфигурацию в двух различных режимах поиска с использованием множеств:
- Открытый абстрактный поиск: ситуация, в которой не существует уникальной эталонной истины, а качество измеряется исключительно свойствами на уровне множества, включая разнообразие, соответствие запросам и связь с базой данных.
- Слабо контролируемый композиционный поиск: ситуация, когда запросы сопоставляются со слабым набором ссылок, который служит лишь одним из возможных вариантов реализации намерения запроса.
Для многомодальных основ встраивания мы провели эксперименты в двух областях: крупномасштабный набор данных о моде, содержащий подборки одежды от пользователей, используемый для экспериментов по преобразованию текста в изображение (оценка проводилась с помощью средства поиска на основе CLIP), и собственный промышленный набор данных, содержащий плейлисты музыки, созданные экспертами, используемый для оценки преобразования текста в музыку (оценка проводилась с помощью MuLan).
Для языковых моделей процесс генерации запросов осуществлялся с помощью 4B моделей с открытым исходным кодом, а именно Gemma3-4B и Qwen3-4B, которым было поручено генерировать ровно 10 подзапросов для каждого основного поискового запроса, который они обрабатывали. Мы реализовали обучение с подкреплением для этих моделей генерации запросов с помощью Soft-GRPO, подхода, использующего групповую относительную оптимизацию политики с мягкой регуляризацией PPO.
Результаты
Качество и точность поиска
В обеих задачах поиска алгоритм Retrieve-for-Train превзошел традиционный поиск по одному запросу, расширение с нулевым количеством примеров и даже сильно оптимизированный базовый алгоритм Best-of-N.
В качественном отношении базовые модели LLM с нулевым количеством примеров, как правило, генерировали почти синонимичные перефразирования (например, «стиль богемного фестиваля» против «мода богемного фестиваля»), что приводило к избыточным результатам. Retrieve-for-Train генерировал весьма разнообразные, отдельные подзапросы (например, разветвляющиеся на «ботинки» или «шнурки»), которые оставались строго привязанными к многообразию базы данных.
Ускорение вывода на порядок.
Непосредственное применение нашей языковой модели, настроенной с помощью обучения с подкреплением, обеспечило исключительное качество поиска, но при этом она унаследовала стандартные авторегрессионные ограничения по задержке и потребовала больших вычислительных затрат.
Благодаря преобразованию этого изученного поведения в диффузионную модель Retrieve-for-Train с 53,9 млн параметров, мы успешно преодолели узкое место, связанное с задержкой. Поскольку диффузионная модель генерирует все целевые направления одновременно за один параллельный проход без авторегрессии в непрерывном пространстве вложений, она обеспечивает колоссальное ускорение в 12–20 раз по сравнению с авторегрессионными подходами.
В больших масштабах, в то время как авторегрессивная задержка при разветвлении контекста линейно возрастает почти до 50 секунд при обработке больших пакетов контекста, алгоритм Retrieve-for-Train-Diffusion остается в пределах от долей секунды до нескольких секунд, обеспечивая готовый к использованию поиск экспертного уровня с минимальными вычислительными затратами.
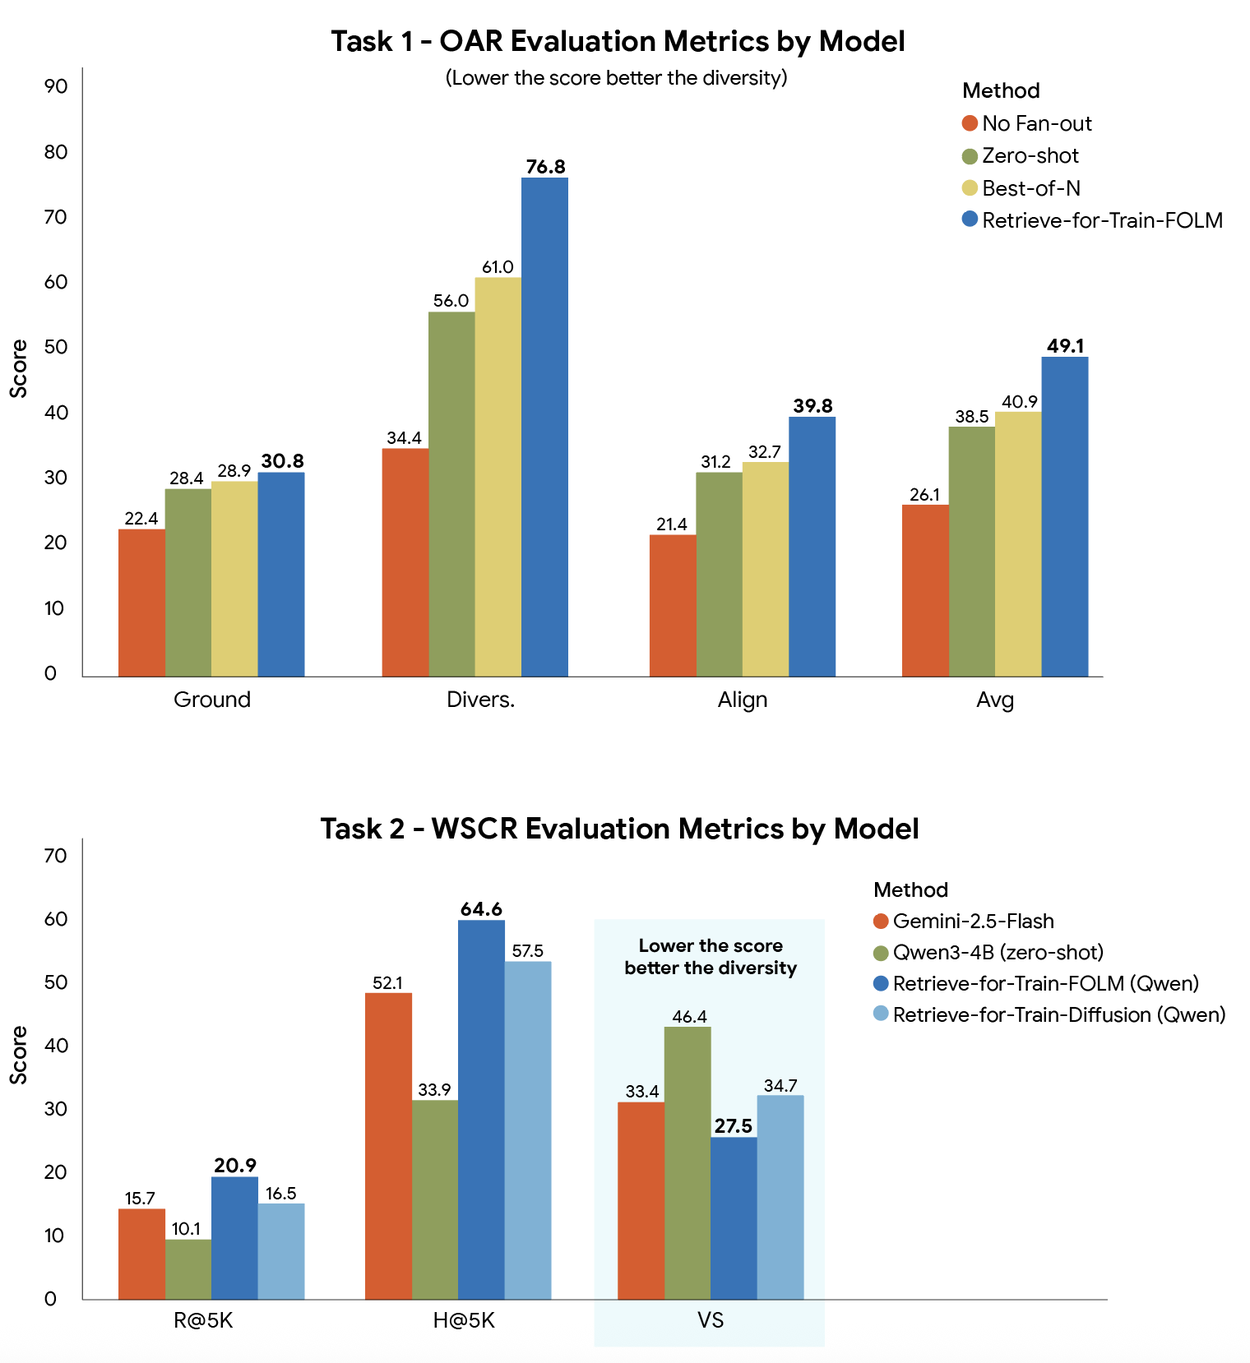
Методика Retrieve-for-Train (FOLM и Diffusion) неизменно превосходит стандартный поиск и базовые методы с нулевым количеством примеров как в задачах поиска абстрактных предложений с открытым концом (OAR), так и в задачах поиска композиционных предложений со слабым контролем (WSCR), обеспечивая значительное улучшение разнообразия, выравнивания и полноты.
Антихакерский якорь (анализ возможностей абляции)
В процессе оптимизации вознаграждения мы обнаружили фундаментальный аспект обучения языковой модели с веерным распределением для поиска. Без термина разнообразия модель быстро начинает генерировать вырожденные, бессмысленные строки (например , «конец строки конец строки» ), чтобы математически использовать векторные координаты базы данных. Внедрение геометрической метрики разнообразия (оценка Венди) действует как важный контр-якорь, заставляя модель находиться в стабильной области пространства вложений, где она может максимизировать свое вознаграждение, только действуя как настоящий эксперт по поиску.
Заключение
Мы продемонстрировали, что обучение с подкреплением может быть весьма эффективным при использовании в качестве одноразового «преобразователя целей», а не в качестве механизма вывода в режиме реального времени. Разделяя трудоемкие вычисления, связанные с исследованием поведения, основанного на вознаграждении, от конечной развернутой модели, наша структура успешно обходит значительную задержку вывода и высокие вычислительные затраты, характерные для развертывания моделей с обучением с подкреплением в режиме реального времени.
Преобразование этих сложных, специфичных для каждого набора данных моделей поведения в легковесное априорное распределение диффузии позволяет системам поиска в производственной среде эффективно оптимизировать свойства более высокого порядка, такие как разнообразие и согласованность. В конечном итоге, Retrieve-for-Train создает масштабируемый и эффективный с точки зрения использования данных конвейер для поиска наборов данных в специализированных или мультимодальных областях, где размеченные человеком пары обучающих данных, согласованные по свойствам, в противном случае являются дефицитными или дорогостоящими. Подробнее см. в статье.
Источник: research.google
Оцените материал: