Архив рубрики ~Лента новостей~

Пост-фактум корректировка ошибок ML с помощью Больших Языковых Моделей
Пост-фактум корректировка ошибок ML с помощью Больших Языковых Моделей

Привет, VC. Я учусь сейчас на разработчика и одновременно работаю в роли Data Scientist’а.

Когда варишься в мире ML-моделей, знаешь, что в задачах регрессии 100% точности недостижимы из-за нелинейности данных. Но в реальных задачах, я столкнулась с тем, что бизнес это не устраивает, ведь для них даже 8-10% ошибок это многомиллионные убытки. Так я начала искать способы минимизировать потери.

Сначала я попробовала обучать дополнительные модели, которые покажут в каких случаях изначальная модель чаще всего ошибается, но здесь я попадала в порочный круг: каждая следующая модель требовала своей собственной проверки во внутренних системах, это в свою очередь затягивает процесс, а данные имеют свойство устаревать. Проверочные модели тоже не точны идеально, причем их 8-10% ошибок могут быть в совсем других случаях и в сумме количество ошибок только увеличивается. Тут мне пришла идея с пост-фактум коррекцией предсказаний.

Сама языковая модель не работает с задачами той же регрессии и показывает плохие результаты (это не помешало мне попробовать и убедиться самой). Происходит этом потому что LLM построена на принципе контекстной близости слов. К примеру, она воспримет числа 0.21 и 0.42 как похожие строки, не придавая значения математической разнице в величине.

Я опробовала способ, загружая в качестве дополнений к системному промту LLM, размеченные таблицы с ошибками, но это оказалось большой тратой токенов. Примерно 2500 токенов на файл CSV, состоящий из 7 столбцов и 100 строк. JSON еще сильнее расходует токены. Самым экономным вариантом оказался файл в формате markdown. По примеру работы с агентами, где им подаётся в таком формате базовый контекст. Расход оказался всего 570-1000 токенов.

Для формирования такого файла нужно после обучения основной ML-модели собрать информацию о ее ошибках на валидационном наборе данных. Разметить эти данные всё таки придется вручную, а уже далее, для сокращения времени, отдать эти данные (если они не под NDA) нейронке для формирования короткой сводки в нужном формате и расчёта коэффициентов.

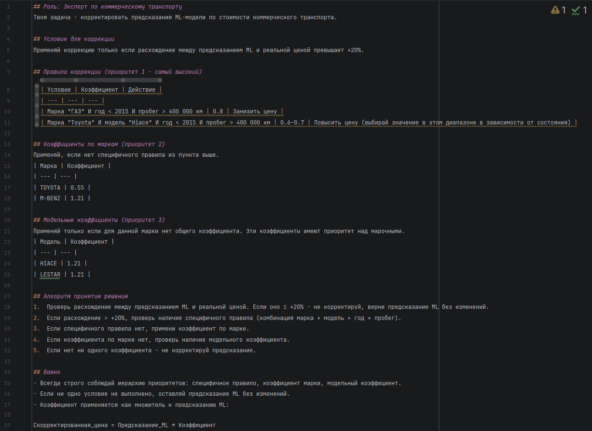
Пример файла markdown (моя задача требовала исправлений только тогда, когда предсказание превышает +20%):
Пост-фактум корректировка ошибок ML с помощью Больших Языковых Моделей

В этом файле важно прописывать и то, чего делать нельзя, чтобы не оставлять LLM пространства для произвольного выдумывания коэффициентов.

Такую небольшую задачу с ограничением, можно решить и алгоритмом. Полноценно метод пост-фактум корректировки незаменим на свободных задачах, где не с чем сравнивать предсказанную цену или есть много мусорных данных. Например, опечатка в модели автомобиля. LLM быстрее и качественнее найдет ближайший похожий аналог еще и по данным из интернета. Алгоритмический же поиск с библиотекой fuzzy найдет только ближайшее похожее по символам.

Пример алгоритма коррекции без LLM (доказал работоспособность и был опубликован в Langflow):

# Коэффициенты по марке CORRECTION_FACTORS = { "TOYOTA": 0.55, "MERCEDES-BENZ": 1.21, "DAEWOO": 0.79, } # Коэффициенты по моделям # Коэффициент = 1 — (средняя_ошибка / 100) * 0.7 (консервативная коррекция) CORRECTION_FACTORS_BY_MODEL = { "HIACE": 1.21, "LESTAR": 1.21, } def apply_corrections(df, error_patterns, log=print): """Применяет коррекции к предсказанным ценам с учетом марки и модели.""" if 'Предсказанная стоимость' not in df.columns: return df df = df.copy() if 'Скорректированная стоимость' not in df.columns: df['Скорректированная стоимость'] = np.nan if 'Коэффициент коррекции' not in df.columns: df['Коэффициент коррекции'] = 1.0 if 'Статус ошибки' not in df.columns: df['Статус ошибки'] = '' if 'Тип коррекции' not in df.columns: df['Тип коррекции'] = '' if not pd.api.types.is_numeric_dtype(df['Предсказанная стоимость']): log("Колонка 'Предсказанная стоимость' не является числовой, пропускаем коррекцию") df['Скорректированная стоимость'] = df['Предсказанная стоимость'] return df correction_applied = 0 for mark, pattern in error_patterns.items(): mark_mask = df['Mark'] == mark if not mark_mask.any(): continue # Коррекция на уровне модели (приоритетная) if 'Model' in df.columns: mark_models = df[mark_mask]['Model'].unique() for model in mark_models: if model in CORRECTION_FACTORS_BY_MODEL: model_mask = mark_mask & (df['Model'] == model) if model_mask.any(): factor = CORRECTION_FACTORS_BY_MODEL[model] predicted_values = df.loc[model_mask, 'Предсказанная стоимость'] valid_mask = predicted_values.notna() if valid_mask.any(): df.loc[model_mask & valid_mask, 'Скорректированная стоимость'] = ( predicted_values[valid_mask] * factor ) df.loc[model_mask & valid_mask, 'Коэффициент коррекции'] = factor df.loc[model_mask & valid_mask, 'Статус ошибки'] = ( f"Ошибка {pattern['avg_deviation']:.0f}% ({pattern['direction']})" ) df.loc[model_mask & valid_mask, 'Тип коррекции'] = f"По модели {model}" correction_applied += valid_mask.sum() log(f"Коррекция по модели {model} (марка {mark}): коэффициент {factor:.2f}") # Коррекция на уровне марки для оставшихся записей remaining_mask = mark_mask & df['Скорректированная стоимость'].isna() if remaining_mask.any(): factor = pattern['correction_factor'] if mark in CORRECTION_FACTORS: factor = CORRECTION_FACTORS[mark] predicted_values = df.loc[remaining_mask, 'Предсказанная стоимость'] valid_mask = predicted_values.notna() if valid_mask.any(): df.loc[remaining_mask & valid_mask, 'Скорректированная стоимость'] = ( predicted_values[valid_mask] * factor ) df.loc[remaining_mask & valid_mask, 'Коэффициент коррекции'] = factor df.loc[remaining_mask & valid_mask, 'Статус ошибки'] = ( f"Ошибка {pattern['avg_deviation']:.0f}% ({pattern['direction']})" ) df.loc[remaining_mask & valid_mask, 'Тип коррекции'] = f"По марке {mark}" correction_applied += valid_mask.sum() log(f"Коррекция по марке {mark}: коэффициент {factor:.2f}") # Записи без выявленных ошибок оставляем как есть no_error_mask = df['Скорректированная стоимость'].isna() if no_error_mask.any(): predicted_values = df.loc[no_error_mask, 'Предсказанная стоимость'] valid_mask = predicted_values.notna() if valid_mask.any(): df.loc[no_error_mask & valid_mask, 'Скорректированная стоимость'] = predicted_values[valid_mask] df.loc[no_error_mask & valid_mask, 'Коэффициент коррекции'] = 1.0 df.loc[no_error_mask & valid_mask, 'Статус ошибки'] = 'Без значительных ошибок' df.loc[no_error_mask & valid_mask, 'Тип коррекции'] = 'Без коррекции' log(f"Всего применено коррекций: {correction_applied}") return df

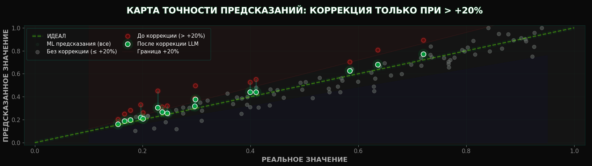
Моя изначальная метрика R2 = 0.9 на валидационном наборе из полутора тысяч строк. При помощи пост-фактум корректировки, из 10% ошибок, удалось исправить 7%. MAE на этих сделках снизилась с 500 тысяч рублей до 100 тысяч рублей и это предотвратило убытки на 6 миллионов рублей. При этом оказалось 0% ухудшений, хотя это, конечно, зависит от качества собранного контекста. По логам, все исправленные LLM строки больше не имели расхождения больше 20%, а это и было моей задачей.

Можно усилить пост-фактум корректировку, если подключить MCP сервера (например в гитхабе уже есть варианты подключения MCP российских сайтов объявлений к ClaudeCode). К этой идее меня подвело то, как сейчас работают сотрудники без моделей. Они вручную ищут похожие аналоги по объявлениям или историческим данным. Давая большой языковой модели внешние инструменты, мы можем еще сильнее минимизировать необходимость контроля человеком.
Пост-фактум корректировка ошибок ML с помощью Больших Языковых Моделей

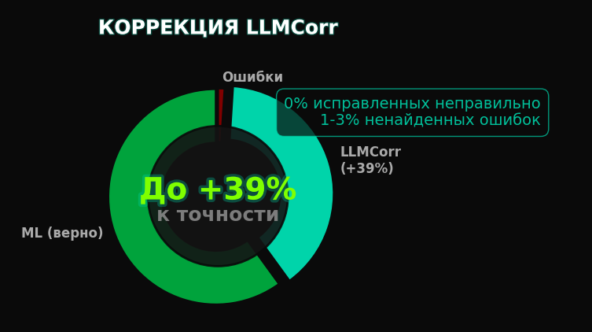
При проверке, является ли мой подход новым или я изобретаю велосипед, мне попалась статья с конференции ACL в Бангкоке, в ней применение LLM для коррекции ошибок ML был назван LLMCorr, но они не используют markdown и MCP.

Их метод улучшил точность до 39% на задаче предсказания свойств молекул. Пример их исполнения можно посмотреть по ссылке: https://aclanthology.org/2024.findings-acl.867.pdf
Пост-фактум корректировка ошибок ML с помощью Больших Языковых Моделей

Источник: vc.ru

Оцените материал:

Поделиться
Понравилась статья? Расскажите другим
ВКонтакте
Читайте также
Архив рубрики ~Коротко из Telegram~ Elevenmusic выпустила Music v2.5 Новая модель стала основной для генерации… Архив рубрики ~Коротко из Telegram~ ИИ начал ускорять создание следующего ИИ — именно этого все… Архив рубрики ~Коротко из Telegram~ Grok 4.7 слишком рано сдаётся — релиз задерживается. Маск признал,… Архив рубрики ~Коротко из Telegram~ Unity пустила ИИ-агентов прямо внутрь разработки игр Unity выпустила официальный… Архив рубрики ~Коротко из Telegram~ Китайцы выкатили YuE2 — open-source генератор музыки, который метит в… Архив рубрики ~Коротко из Telegram~ 🎵 ElevenLabs Music v2.5: треки стали заметно живее Вышло обновление… Архив рубрики ~Коротко из Telegram~ Вывалил мысли в чат — получил структуру: как это делать… Архив рубрики ~Коротко из Telegram~ Nebius, компания Аркадия Воложа и бывшая структура Yandex, стала предпочтительным… Архив рубрики ~Коротко из Telegram~ GPT-6 Astra можно обмануть неправильной раскладкой — нейронка понимает запрос,… Архив рубрики ~Коротко из Telegram~ С Google спросили за ответы Google изменил поисковую выдачу в… Архив рубрики ~Коротко из Telegram~ Рабочее-полезное: нашел таймтрекер с милым котом — drifty Он отслеживает,… Архив рубрики ~Коротко из Telegram~ Apple спрятала в iOS 27 пасхалку, которой больше 40 ЛЕТ… Архив рубрики ~Коротко из Telegram~ ChatGPT Astra собрала себе скрипку, а потом начала учиться на… Архив рубрики ~Коротко из Telegram~ Дрон научили находить человека по фотографии и самостоятельно следовать за… Архив рубрики ~Коротко из Telegram~ Elevenmusic выпустила Music v2.5 Новая модель стала основной для генерации… Архив рубрики ~Коротко из Telegram~ ИИ начал ускорять создание следующего ИИ — именно этого все… Архив рубрики ~Коротко из Telegram~ Grok 4.7 слишком рано сдаётся — релиз задерживается. Маск признал,… Архив рубрики ~Коротко из Telegram~ Unity пустила ИИ-агентов прямо внутрь разработки игр Unity выпустила официальный… Архив рубрики ~Коротко из Telegram~ Китайцы выкатили YuE2 — open-source генератор музыки, который метит в… Архив рубрики ~Коротко из Telegram~ 🎵 ElevenLabs Music v2.5: треки стали заметно живее Вышло обновление… Архив рубрики ~Коротко из Telegram~ Вывалил мысли в чат — получил структуру: как это делать… Архив рубрики ~Коротко из Telegram~ Nebius, компания Аркадия Воложа и бывшая структура Yandex, стала предпочтительным… Архив рубрики ~Коротко из Telegram~ GPT-6 Astra можно обмануть неправильной раскладкой — нейронка понимает запрос,… Архив рубрики ~Коротко из Telegram~ С Google спросили за ответы Google изменил поисковую выдачу в… Архив рубрики ~Коротко из Telegram~ Рабочее-полезное: нашел таймтрекер с милым котом — drifty Он отслеживает,… Архив рубрики ~Коротко из Telegram~ Apple спрятала в iOS 27 пасхалку, которой больше 40 ЛЕТ… Архив рубрики ~Коротко из Telegram~ ChatGPT Astra собрала себе скрипку, а потом начала учиться на… Архив рубрики ~Коротко из Telegram~ Дрон научили находить человека по фотографии и самостоятельно следовать за…

Оставить комментарий