Почему искусственный интеллект Google не может написать слово Google (или что-либо еще)?
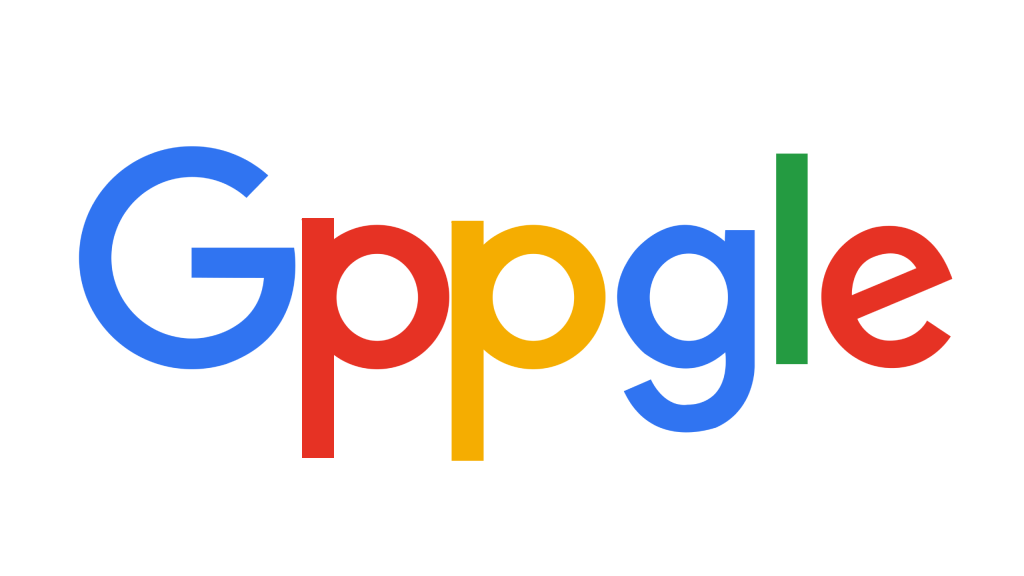
Сколько букв «P» в слове «Google»? По данным Google, их две.
В обзоре искусственного интеллекта Google также говорится, что в слове «poop» (какашки) «ровно одна буква 'r'», а в слове «journaism» (журналистика) две буквы «d», но написано оно так: journadism. Google, по крайней мере, определил, что в фамилии президента США есть одна буква «p», но написал её как trpum.
Не нужно было быть пророком, чтобы предсказать, что масштабная модернизация поиска Google с использованием ИИ будет воспринята негативно. Мы уже делали это раньше. Когда Google впервые добавил в поиск функцию «Обзоры ИИ», она в итоге ссылалась на сатирические посты из The Onion и Reddit, советовавшие людям есть камни и клеить пиццу.
На этот раз, когда Google удваивает свои усилия по превращению генеративного искусственного интеллекта в центральный элемент своего флагманского продукта, существующего уже 29 лет, неудивительно, что компания терпит неудачу.
Google полностью переделывает свою поисковую систему, вот так, кстати. pic.twitter.com/PIR4llFhiV
— mersomas (@mersomas) 27 мая 2026 г.
«Подсчет слов — известная проблема для магистров права, и мы работаем над ее решением», — сообщила Google изданию TechCrunch в электронном письме.
Эти элементарные орфографические ошибки могут показаться знакомыми. LLM-ы, тип искусственного интеллекта, используемый в чат-ботах и других генераторах текста, не предназначены для понимания орфографии. Уже много лет существует шутка, что всякий раз, когда компания представляет новую модель ИИ, следует спросить её, сколько букв «р» в слове «клубника». Эти модели ИИ — которые могут написать приложение за секунды или решить задачи, которые десятилетиями ставили математиков в тупик, — по уровню правописания примерно соответствуют уровню ребёнка из детского сада.
Проблемы Google с обзором ИИ выходят за рамки глупых орфографических ошибок. Google уже исправил проблему прошлой недели, из-за которой при поиске слова «disregard» отображалось что-то вроде словарного определения, но на самом деле оно выглядело так: «Понятно. Дайте мне знать, когда у вас появится новый запрос или вопрос!». Но эти орфографические ошибки остаются забавными, потому что их так сложно исправить.
Как уже объясняли исследователи, когда мы спрашивали их о подобных проблемах с правописанием, ИИ не воспринимает предложения как единицы языка, состоящие из слов и букв. Многие языковые модели построены на основе трансформерных моделей, которые разбивают текст на токены, представляющие собой целые слова, слоги или буквы, в зависимости от модели. Вместо того чтобы «читать» так, как это делал бы человек, ИИ преобразует текст в числовые представления самого себя, которые затем контекстуализируются, чтобы помочь ИИ придумать логичный ответ.
«LLM-ы основаны на архитектуре трансформера, которая, что примечательно, фактически не читает текст. Когда вы вводите запрос, он преобразуется в кодировку», — рассказал TechCrunch Мэтью Гуздиал, исследователь в области искусственного интеллекта и доцент Университета Альберты. «Когда он видит слово „the“, у него есть одна кодировка того, что означает „the“, но он ничего не знает о „T“, „H“, „E“».
Архитектура, основанная на токенах, которая лежит в основе таких программ обучения лингвистике, как обзор искусственного интеллекта от Google, по своей сути имеет ограничения, и исследователи не питают оптимизма по поводу возможности решения проблемы с орфографией.
«Довольно сложно обойти вопрос о том, что именно должно представлять собой „слово“ для языковой модели, и даже если бы эксперты-люди пришли к согласию относительно идеального словаря токенов, моделям, вероятно, все равно было бы полезно „разбивать“ данные на более мелкие части», — сказала Шеридан Фойхт, аспирантка, изучающая интерпретируемость больших языковых моделей в Северо-восточном университете, в интервью TechCrunch. «Я предполагаю, что идеального токенизатора не существует из-за такой неопределенности».
Это не обязательно является неотложной проблемой для исследователей, поскольку польза от использования программ обучения на основе лингвистических знаний не заключается в их способности правильно писать. Но эти вопиющие недостатки помогают нам помнить, что ИИ не идеален, даже если иногда он может казаться всезнающей силой, непостижимой для нас. Мы не можем слепо доверять результатам работы ИИ, не перепроверяя их точность.
Источник: techcrunch.com
Оцените материал: