Как я сделал локальный RAG-сервис для SRE: ищем по документации, ранбукам и коду через Ollama
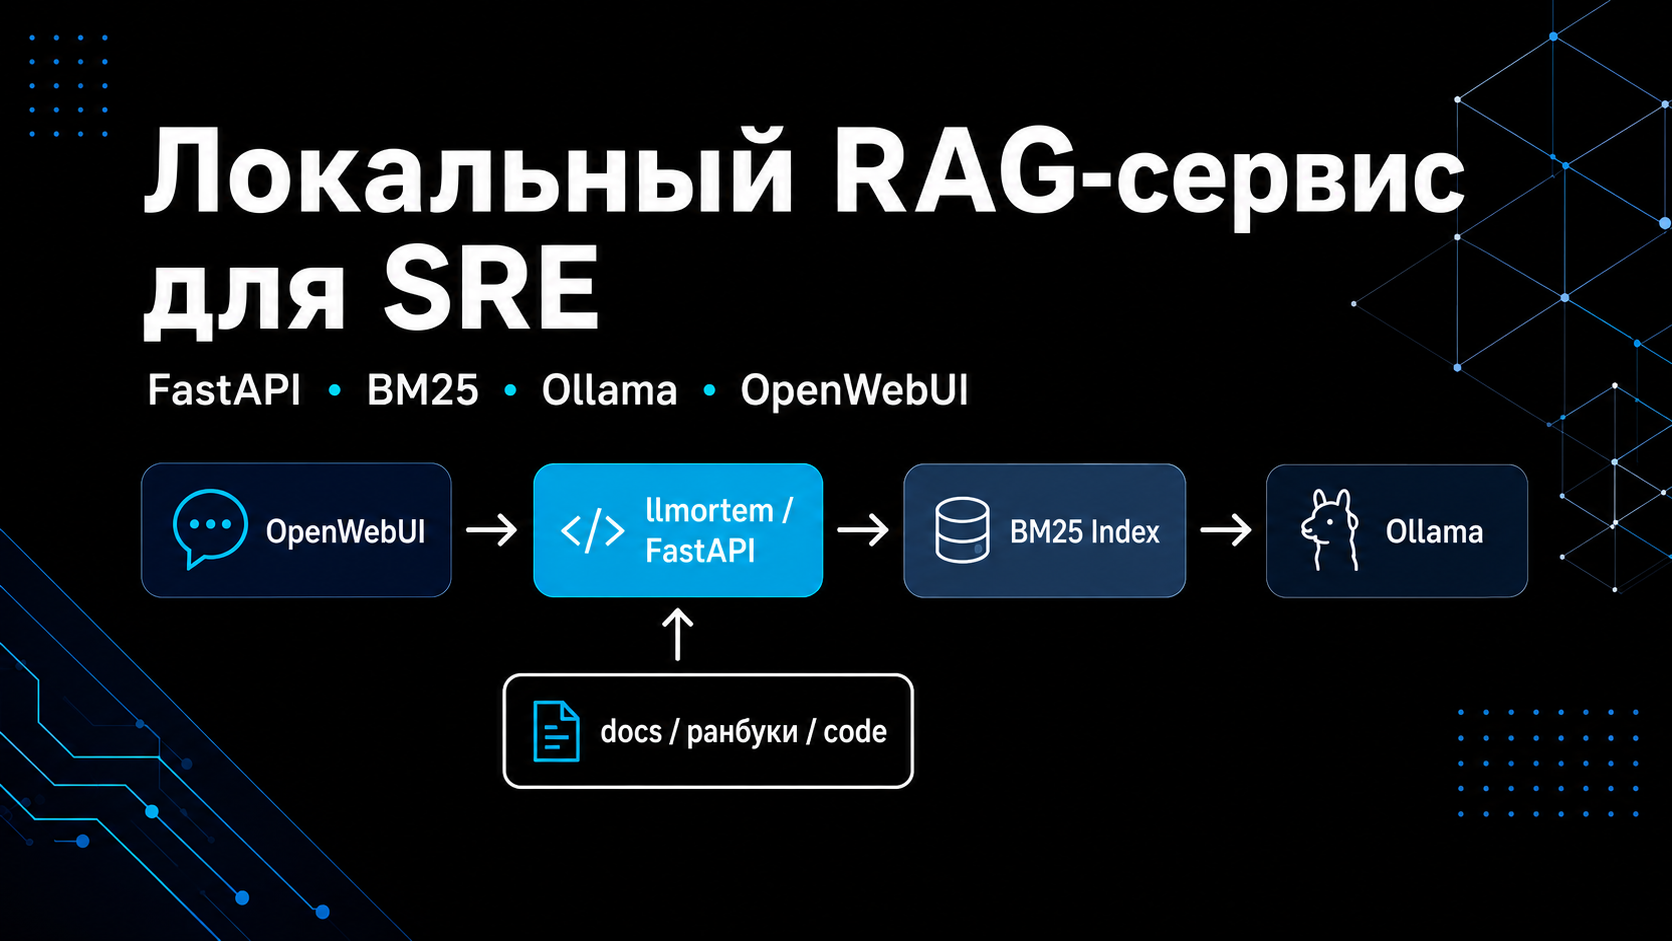
Недавно делал учебный проект про автоматизацию документирования инцидентов. Поначалу планы были грандиозными: инциденты, таймлайны, интеграции с мониторингами, чатами, постмортемы, подсказки дежурным инженерам.
Но довольно быстро стало понятно, что с временными и ресурсными ограничениями лучше не пытаться написать маленький PagerDuty. Поэтому я сузил задачу до более реалистичного ядра: локального RAG-сервиса, который ищет по документации, ранбукам и коду, а затем передаёт найденный контекст в LLM.
Так появился llmortem — FastAPI-сервис, который можно подключить к OpenWebUI как OpenAI-compatible backend.
В статье расскажу, как устроена архитектура, почему я начал с BM25, зачем индексировать docstring’и и какие ограничения у такого подхода.
Читать далее
Источник: habr.com
Оцените материал: