Исследователи Salesforce добились того, что ИИ-агент стал выполнять 93% задач в браузере, не затрагивая саму модель.
Бен Диксон
Самосовершенствующиеся ИИ-агенты могут анализировать свои ошибки и изменять подсказки, инструменты, навыки и рабочие процессы, основанные на базовой модели, или «оболочке». Однако надежное наращивание этих улучшений затруднительно. Изменение, помогающее в одной задаче, может ухудшить работу агента в другой, в то время как многократное улучшение одной версии оболочки может привести систему к застою, который в конечном итоге приведет к остановке работы.
Новая платформа DarwinX от Salesforce AI Research и Salesforce Agentforce использует эволюционный подход к этой проблеме. Вместо постоянного переписывания одной версии агента, она исследует несколько альтернатив, сохраняет полезные открытия и позволяет вносить изменения только тогда, когда они улучшают возможности, не ухудшая при этом другие задачи.
Эксперименты показывают, что из этого слоя можно извлечь много потенциала для повышения производительности. Как сообщают исследователи, усовершенствование инструментария улучшило результаты агента по всем четырем протестированным бенчмаркам, от прироста в 3,4 балла на SWE-bench Verified до скачка на 49,5 балла на WebArena-Infinity.
DarwinX изменяет только вспомогательный код, но никогда не меняет веса модели. Это делает данный подход актуальным для разработчиков приложений, которые используют размещенные модели и не имеют собственных конвейеров тонкой настройки или обучения моделей.
Почему существующие циклы самосовершенствования заходят в тупик
Многие фреймворки для самосовершенствующихся агентов используют тот или иной вариант одного и того же базового цикла: запуск агента на пакете задач, анализ траекторий, выявление сбоев, предложение изменений в программном обеспечении и тестирование модифицированного агента на валидационном или регрессионном наборе данных.
Исследователи уже расширили эту идею за пределы оптимизации подсказок. Например, машина Дарвина-Гёделя (DGM) позволяет агенту изменять собственный исходный код и поддерживает архив прошлых вариантов. HarnessX работает непосредственно с подсказками, инструментами и потоком управления, а также разделяет варианты по семействам задач для предотвращения помех.
Однако исследователи Salesforce выявили две проблемы, связанные с этими подходами.
Первая проблема — это «зависимость от предшествующего пути». Если каждый раунд строится на основе того агента, который в данный момент выглядит лучше всего, ранние изменения определяют основу для всего последующего. Локально полезная правка может направить эволюцию по ветви, которая в конечном итоге остановится, в то время как другая многообещающая ветвь будет заброшена, прежде чем успеет развиться.
Представьте, что ранняя редакция учит агента кодирования агрессивно устанавливать зависимости перед выполнением задачи. Она исправляет несколько ошибок, и это становится новой базовой версией. Каждая последующая редакция теперь строится на основе этого поведения. Между тем, система может упустить из виду альтернативную стратегию, которая сначала проверяет среду и устанавливает только то, что необходимо.
Вторая проблема — «межзадачное взаимодействие». Изменение, помогающее одному классу задач, может незаметно навредить другому. Например, инструкция по выполнению обширной проверки может улучшить сложные задачи научных вычислений, но привести к превышению временного лимита для более простых задач. Чем шире становится распределение задач агента, тем сложнее вносить локальные улучшения без ущерба для существующих возможностей.
Те же проблемы уже знакомы командам предприятий, которые вручную исправляют подсказки и рабочие процессы после сбоев. В комментариях, предоставленных VentureBeat, Ран Сюй, старший автор статьи о DarwinX, сказал: «Ручная разработка тестовых сценариев может легко привести к локальному оптимуму: вы исправляете подсказку или рабочий процесс для одного режима отказа, но без широкого регрессионного тестирования вы можете незаметно сломать то, что уже работало».
Оценка работы агентов добавляет еще одну сложность. Результаты носят стохастический характер, поэтому один и тот же агент может выполнить задачу в одном запуске и не выполнить ее в другом. Исследователи ссылаются на предыдущие исследования, в которых измерялись колебания в несколько процентных пунктов между различными запусками отраслевых эталонных тестов. Эти колебания могут быть такими же значительными, как и очевидная выгода от отдельной модификации программного обеспечения.
Поэтому широкое регрессионное тестирование так же важно, как и устранение неисправности, которая изначально привела к замене жгута проводов.
Таким образом, задача состоит в том, чтобы определить, какие улучшения являются реальными, сохранить полезные альтернативы и объединить новые возможности, не теряя при этом старые.
DarwinX позволяет конкурировать между собой в плане улучшений.
DarwinX рассматривает это как проблему отбора. Вместо того чтобы поддерживать одну постоянно переписываемую версию программного обеспечения, он генерирует различные варианты и сохраняет их в архиве. Перспективные версии могут продолжать развиваться, в то время как полезные открытия из других ветвей остаются доступными для дальнейшего использования. Базовая LLM остается неизменной.
Первый ключевой механизм — это то, что исследователи называют «сохранением и расширением».
Предлагаемый вариант программного обеспечения должен улучшать что-то, не допуская при этом регрессии в ранее решенных задачах в пределах допустимых значений. Проще говоря, решение задачи B не считается значительным улучшением, если одно и то же изменение нарушает работу задач A и C.
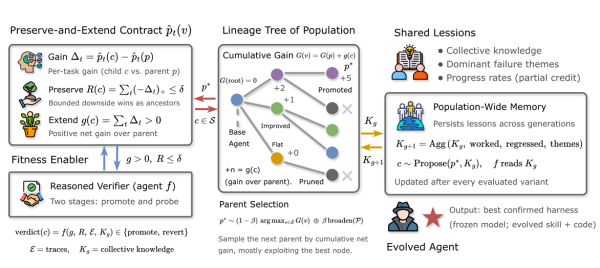
DarwinX также разделяет этапы исследования и подтверждения. Перспективная версия с минимальными недостатками может пройти начальный этап проверки. Но прежде чем ей будет доверено руководство дальнейшим развитием, система повторно запускает ее с более высокой точностью и исследует задачи, которые уже были решены в предыдущих версиях. Это затрудняет возможность для одного удачного запуска перенаправить поиск.
DarwinX может обеспечить соблюдение этой дисциплины, поскольку результаты его экспериментов с кодом и браузером можно проверить относительно надежно. Это позволяет системе проверить, добавляет ли изменение в тестовой среде новые возможности, сохраняя при этом задачи, которые уже были решены в предыдущих версиях.
Для инженеров-программистов принцип сохранения и расширения очень похож на непрерывную интеграцию для агента: предложить изменение, протестировать новое поведение, повторно запустить ранее успешно прошедшие тесты, и только после этого позволить кандидату влиять на будущие версии. Как выразился Сюй: «Ключевой момент в том, что DarwinX не просто объединяет изменения и предполагает, что результат лучше. Объединенный агент все еще должен пройти этапы сохранения и подтверждения, сохраняя взаимодополняющие преимущества без регресса в ранее решенном поведении».
Второй механизм решает проблему зависимости от пути выполнения. DarwinX сохраняет альтернативные ветви, включая варианты, которые показывают худшие результаты по совокупным метрикам. Ветвь может демонстрировать худшие общие показатели, но содержать единственное изменение, решающее конкретный класс задач. Вместо того чтобы отбрасывать эту работу, DarwinX может рассматривать её как специализированную.
Когда разные специалисты обладают взаимодополняющими сильными сторонами, структура может объединить их аддитивные изменения в новую систему. Объединенная версия должна затем доказать, что она сохраняет соответствующие преимущества своих родительских элементов. Это позволяет улучшениям, обнаруженным на разных эволюционных путях, снова встретиться, вместо того чтобы оставаться в ловушке отдельных ветвей.
DarwinX также может использовать различные источники при предложении следующего изменения. Он может анализировать неудачные траектории, учиться на успешной траектории более сильного учителя или сравнивать собственные успешные и неудачные попытки агента выполнить одну и ту же задачу. Все три сигнала приводят к внесению изменений в настройки, а не к изменению весов модели.
Исследователи также объединяют повторяющиеся сбои в общую память. Например, если несколько задач завершаются с ошибкой из-за слишком длительного времени настройки среды, система может предложить многократно используемый вариант настройки вместо создания исправления для каждой задачи по отдельности.
Здесь «естественный отбор» в DarwinX приобретает более буквальный смысл. Системе не нужны эталонные решения, и исследователи не проводят ручную проверку кандидатов и не выбирают победителя. Варианты системы выживают на основе измеренной приспособленности под воздействием оценщика задачи.
Это не означает, что DarwinX работает без сигнала оценки. Ему по-прежнему необходим способ определения того, была ли задача выполнена успешно. Например, в своих экспериментах с WebArena-Infinity исследователи использовали LLM-судью для оценки траекторий, сгенерированных различными вариантами их агента.
Этот процесс отбора также отличает DarwinX от таких систем, как DGM и HarnessX. У DGM уже есть открытый архив, но он мутирует только одного родителя за раз и не имеет слияния между линиями происхождения, как у DarwinX, или явного контракта на сохранение. HarnessX изолирует варианты, чтобы предотвратить интерференцию, в то время как DarwinX стремится безопасно объединить взаимодополняющие возможности.
DarwinX в действии
Исследователи протестировали DarwinX на Monet, собственном агенте Salesforce. При сравнении с исходной моделью базовая модель оставалась неизменной.
Оценки становятся все сложнее обмануть путем переобучения. В первом раунде экспериментов агент развивается и оценивается на одном и том же эталонном наборе данных. Во втором раунде агенты тестируются на отложенных задачах. На третьем этапе модель агента развивается на синтетических задачах для браузера и оценивается на неизвестных реальных задачах. В заключительном эксперименте модель, разработанная на одном эталонном наборе данных, переносится на совершенно другой эталонный набор данных.
Как сообщают исследователи, на тестовом наборе данных Terminal-Bench 2.1 DarwinX повысил оценку Monet на замороженном GPT-5.5 с 75,5% до 83,2%, а с более сильной базовой моделью — до 84,7%. Наибольшие улучшения были достигнуты в задачах машинного обучения и научных вычислений, где оценка выросла на 14,8 балла, а также в задачах обработки данных и баз данных, где она увеличилась на 13,8 балла.
Но важнее, чем скачок в результатах, являются изменения, которые привели к этим улучшениям. В усовершенствованную систему были добавлены семь навыков, которые указывают агенту, как должен выглядеть правильный результат, проверять сгенерированные файлы и значения перед завершением работы, а также интегрировать выходные данные в реальную работу инструмента.
Усовершенствованный агент не просто увеличил вычислительные ресурсы для вывода результатов. В задачах, которые обе версии уже могли решить, среднее количество ходов увеличилось лишь с 12 до 13. В отличие от этого, в шести новых решенных задачах оно удвоилось, увеличившись с 11 до 22. Это означает, что система научилась определять, где дополнительная проверка и повторные попытки оправданы.
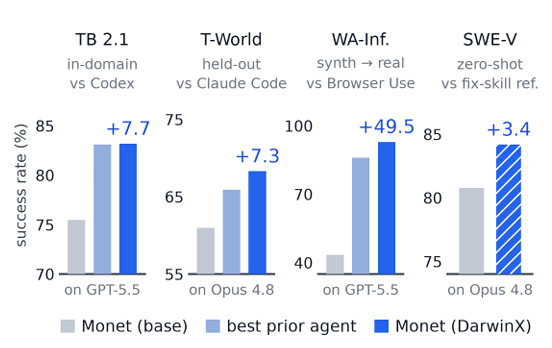
TerminalWorld наглядно демонстрирует, почему DarwinX использует несколько ветвей. Тестовая среда развивалась на основе 94 задач обучения, а затем была заморожена перед тестированием на 41 отдельной задаче. Согласно статье, на Opus 4.8 базовая версия решила 25 из 41 задачи, или 61%, в то время как DarwinX решил 28, или 68,3%.
Что еще более интересно, четыре специализированных варианта решили 24, 25, 26 и 27 заданий, не включенных в тест, на разных перекрывающихся подмножествах. Объединенная система достигла результата в 28 заданий, превзойдя все специализированные варианты. Исследователи называют Opus 4.8 главным результатом, поскольку та же процедура на GPT-5.5 достигла 56,1%, что ниже, чем у нейтрального базового агента, и они описывают разницу в одно задание по сравнению с самым сильным стандартным агентом как показательную, а не статистически значимую.
Сюй указывает на этот результат как на доказательство того, что совокупные баллы могут скрывать полезные возможности. «Вариант с более низким баллом может по-прежнему содержать единственное успешное поведение для определенного класса задач», — сказал он.
Практическим аналогом в корпоративной среде может служить агент реагирования на инциденты. Лучшая универсальная версия может надежно проверять сервисы, запускать стандартную диагностику и подготавливать безопасные изменения кода. Специалист с более низким рейтингом может разработать надежный рабочий процесс авторизации Kubernetes, в то время как другой может лучше справляться с восстановлением базы данных и проверкой артефактов. Ни один из специалистов не обязательно должен быть достаточно хорош для развертывания самостоятельно, чтобы его изменения в среде разработки были полезными. DarwinX может сохранить эти особенности поведения, объединить их с другими, а затем подвергнуть объединенную версию тем же регрессионным проверкам перед ее продвижением.
Результат TerminalWorld представляет собой измеренное подтверждение этой аналогии. В статье не приводится отдельное указание на то, какая часть прироста обусловлена самой рекомбинацией, а какая — другими компонентами системы DarwinX.
В экспериментах WebArena-Infinity компания DarwinX усовершенствовала браузерную среду на основе 300 синтетических интентов, сгенерированных из документации приложения. Финальный тест включал 1260 ранее не встречавшихся задач с детерминированными верификаторами, а не с использованием LLM-судьи для оценки вариантов в процессе эволюции. После заморозки GPT-5.5 исследователи сообщают об увеличении производительности агента с 43,5% до 93% — более чем вдвое, без изменения весов модели. Этот показатель был получен после проверки траекторий на предмет недопустимого или эксплойтного поведения.
Наконец, исследователи взяли тестовый стенд, разработанный на Terminal-Bench, и запустили его без изменений на SWE-bench Verified. Согласно статье, он достиг 84,2% по сравнению с 80,8% для эталонного стенда, не получая обратной связи от SWE-bench в процессе разработки. Результат свидетельствует о том, что некоторые из изученных моделей поведения тестового стенда могут переноситься за пределы бенчмарка, на котором они были разработаны, хотя в статье проверяется этот перенос только в одном направлении.
Что DarwinX значит для разработчиков
Главное практическое преимущество DarwinX заключается в том, что цикл улучшения работает на уровне, который уже контролируется разработчиками приложений. Доступ к весам модели не требуется.
По мере совершенствования базовых моделей этот окружающий слой может стать не менее важным, а более значимым. Система должна адаптироваться к особенностям использования инструментов каждой модели, контекстным требованиям и режимам сбоев. Она также содержит специфическую для предприятия информацию, которую универсальная модель не может просто изучить во время предварительного обучения: данные в реальном времени, рабочие процессы, разрешения, идентификация, правила управления, инструменты и поверхности действий.
«Модель может обладать более общими способностями к рассуждению, в то время как инструмент все больше отражает специфический для предприятия контекст, действия, управление и уровень адаптации вокруг модели», — сказал Сюй. «Это может стать гораздо более надежным источником дифференциации, чем любой конкретный запрос».
Более сложная задача — создание инфраструктуры оценки, которая определяет, что значит «лучше» в цикле развития. В отличие от эталонных тестов кода, в реальных корпоративных рабочих процессах редко встречается хотя бы один корректный бинарный верификатор.
Сюй утверждает, что предприятиям следует решать эту проблему, фиксируя происходящее во время реальной работы и постепенно превращая эти данные в сигналы для обучения и оценки. Рассмотрим оператора службы поддержки клиентов. Компания могла бы записывать действия оператора, изменения состояния заявки, исправления, внесенные человеком, эскалации, проверки политики, утверждения и последующие результаты. Некоторые из этих сигналов могут стать детерминированными проверками: достигло ли дело правильного состояния, завершилась ли утвержденная транзакция или содержала ли база данных ожидаемое значение? Другие могут поступать от исправлений, внесенных человеком, проверок на соответствие требованиям, результатов бизнеса или согласия нескольких оценщиков.
«Предприятиям не обязательно нужна единая идеальная функция вознаграждения, — сказал Сюй. — Им нужен инфраструктурный уровень, который постоянно преобразует реальную работу во все более эффективную корпоративную аналитику».
Со временем эта инфраструктура может создавать постоянно обновляемый набор оценочных инструментов, основанный на рабочих процессах, с которыми агент фактически сталкивается. Это решает одну из основных практических проблем, выявленных в статье: производственные задачи редко поступают с надежными средствами проверки. Вместо того чтобы развивать агента непосредственно на основе реальных запросов, команды могут периодически запускать развитие на основе поддерживаемого прокси-набора и развертывать версию, которая проходит проверку на регрессионный уровень.
Компания Salesforce также предоставила инфраструктуру для экспериментов с этим подходом через Beagle, открытый фреймворк, доступный на GitHub под лицензией Apache 2.0. Monet остается проприетарным, но команды могут использовать собственные агентские среды в Beagle. DarwinX — это метод эволюции, который ищет, оценивает и выбирает варианты среды, а Beagle предоставляет более широкую инфраструктуру для запуска развертываний и экспериментов с агентами, средами, наборами данных и методами эволюции.
Сюй описывает Beagle как «тренажер для развития агентов, имитирующий обнимающееся лицо»: «Вы предоставляете агента, среду, оценочный сигнал и алгоритм эволюции, а инфраструктура обеспечивает масштабируемое развертывание и экспериментирование».
Переход от ручного обновления запросов к такому автоматизированному CI-процессу имеет свою цену. DarwinX исследует множество вариантов, повторяет оценки для учета некорректных результатов и запускает проверки на сохранение данных, прежде чем кандидаты смогут повлиять на последующие поколения. Это требует больших вычислительных мощностей и инфраструктуры, чем ручное редактирование запросов. Но ручные обновления также требуют регрессионного тестирования, если они предназначены для внедрения в производство. Разница заключается в том, что автоматизированный цикл может проводить эти эксперименты систематически, вместо того чтобы требовать от инженера проверки и исправления ошибок по одной.
Команды также могут ограничивать затраты. Эволюция может работать в рамках фиксированного вычислительного бюджета и останавливаться, когда улучшения достигают плато. «Цель состоит в том, чтобы тратить вычислительные ресурсы на оценку до тех пор, пока незначительное улучшение перестанет оправдывать затраты», — сказал Сюй. Для предприятия актуальным компромиссом является время, затрачиваемое на разработку, и риск регрессии, а также затраты на вывод результатов: как быстро система достигает требуемого уровня качества и сколько регрессий в производственной среде предотвращает автоматизированный цикл тестирования и отбора?
Это также означает, что DarwinX подходит не для каждого агента. Сюй рекомендует эволюционную оптимизацию для долгосрочных задач, где результаты можно оценить с достаточной степенью достоверности и которые имеют большую поведенческую поверхность (например, подсказки, навыки, инструменты, память, поток управления или исходный код).
Напротив, добавление механизмов трудно оправдать для простого и стабильного рабочего процесса, такого как преобразование известных входных данных в фиксированный вызов API и возврат результата. «Я бы не стал вводить эволюцию на основе популяций просто так», — сказал Сюй. Детерминированный рабочий процесс обычно проще понять, протестировать и контролировать.
Существует также золотая середина. Корпоративный агент по обслуживанию клиентов может охватывать достаточно много изменяющихся рабочих процессов, чтобы извлечь выгоду из непрерывного совершенствования, не требуя при этом полномасштабного эволюционного поиска на основе всей популяции. Команды по-прежнему могут использовать основную дисциплину DarwinX: преобразовывать типичные ошибки и отзывы людей в предлагаемые изменения в подсказках, рабочих процессах, операциях с базами данных, вызовах функций или интеграциях и проверять эти изменения с помощью набора регрессионных тестов. Более простой линейный поиск или поиск по принципу «лучший в первом случае» может быть достаточным, когда задача не оправдывает поддержание полной популяции вариантов.
Источник: venturebeat.com
Оцените материал: