Анализ результатов GLM-5.3 компании Zhipu, выходящих за рамки основного показателя.

Искусственный интеллект с открытым исходным кодом и демократизацией
Анализ результатов GLM-5.3 компании Zhipu, выходящих за рамки основного показателя.
В примечаниях к выпуску GLM-5.3 от компании Zhipu содержится предложение, которое не попало в большинство публикаций. Описывая собственные результаты в области кибербезопасности, пекинская компания пишет, что эта возможность «развивается быстрее всего именно там, где мы больше всего отстаем».
Компания Zhipu, также известная под торговой маркой Z.ai, является одной из немногих китайских лабораторий, выпускающих модели, конкурирующие с американскими разработками. 14 августа она запустила GLM-5.3, модель, ориентированную на программирование, и опубликовала техническое описание, в котором изложены результаты работы модели по сравнению с конкурентами. Это описание является источником всей информации, представленной здесь.
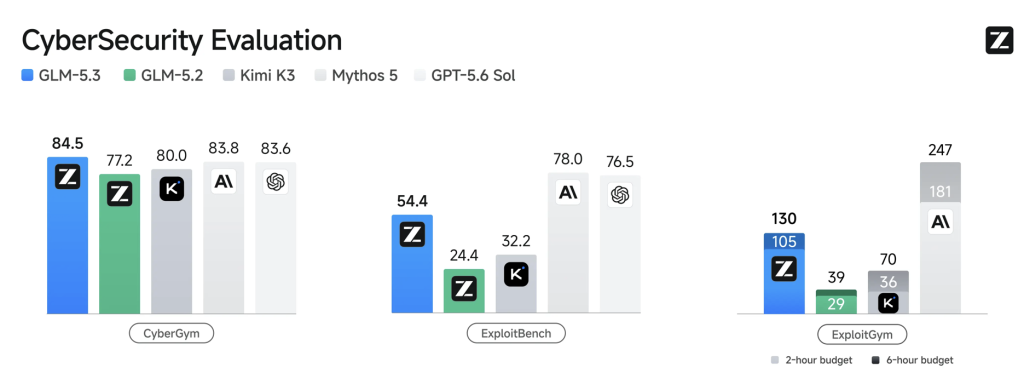
Распространялось утверждение, касающееся безопасности. Наряду с результатами кодирования, Чжипу заявил, что GLM-5.3 неожиданно хорошо справляется с поиском уязвимостей программного обеспечения, набрав 84,5% в бенчмарке CyberGym против 83,8% у Anthropic's Mythos 5 и 83,6% у OpenAI GPT-5.6 Sol. Затем появились заголовки о том, что китайская модель теперь превосходит американские по эффективности поиска ошибок.
Причина, по которой результаты, полученные с помощью этой модели, оказываются более сложными, чем обычные бенчмарки, заключается в том, что стало характерной чертой обнаружения уязвимостей. Модель, способная анализировать код и находить уязвимости, полезна для защитника, проводящего аудит собственного программного обеспечения, и полезна для любого, кто делает то же самое с чужим. По этой причине аналогичная работа Anthropic находится в режиме ограниченного доступа, в то время как Zhipu планирует опубликовать веса GLM-5.3 для скачивания любым желающим.
Собственный пресс-релиз Zhipu более сдержан, чем освещение событий в прессе. Показатель CyberGym реален, и он опубликован в статье. Кроме того, это самый узкий из трех результатов по кибербезопасности, опубликованных компанией, и Zhipu открыто заявляет, что два других показателя противоположны.
Три контрольных показателя, три разных картины
CyberGym начинает с исходного кода, который модель может прочитать, и проверяет, может ли она обнаружить уязвимость и подтвердить ее подлинность. Это результат, который был получен, и разница составляет семь десятых процента.
ExploitBench задает более сложный вопрос, требуя от модели анализа реальной уязвимости и способов ее эксплуатации. GLM-5.3 набирает 54,4%, что более чем вдвое превышает результат предшественника (24,4%). Mythos 5 набирает 78,0%, а GPT-5.6 Sol — 76,5%.
ExploitGym подсчитывает, сколько задач по эксплуатации модель выполняет в рамках фиксированного временного бюджета. GLM-5.3 выполняет 105 задач за два часа и 130 за шесть. Mythos 5 выполняет 181 и 247 задач соответственно.
Эти два результата были освещены недостаточно подробно, и именно они описывают существующий разрыв. Обнаружение уязвимости и создание на её основе работающего эксплойта — это разные задачи. По мнению компании Zhipu, чем дальше по этой цепочке находится тест, тем больше он отстаёт от модели, и компания прямо заявляет об этом в пресс-релизе, вместо того чтобы позволить ему обнаружить это самостоятельно.
Какая именно антропическая модель используется и почему она постоянно меняется?
Часть путаницы в обзоре возникает из-за того, что Zhipu сравнивает три разные модели Anthropic в трёх разных местах. В основной таблице сравнения GLM-5.3 сравнивается с Opus 4.8. В графиках производительности используется Fable 5. В разделе, посвящённом кибербезопасности, используется Mythos 5. Любой, кто читает быстро, получает представление о единственном сравнении, которого не существует.
В плане программирования ситуация неоднозначна, но явных лидеров нет. GLM-5.3 опережает Opus 4.8 в одних тестах и отстает в других, а Zhipu прямо заявляет, что ее модель по-прежнему отстает от Claude Fable 5 в собственном внутреннем тесте компании по программированию.
Как проводились тесты
В сносках к методологии содержится информация, которая была пропущена в кратких описаниях. Чжипу оценил GLM-5.3 на CyberGym, ExploitGym, ExploitBench, Terminal Bench и нескольких других задачах внутри Claude Code 2.1.207, агента кодирования Anthropic.
В этом нет ничего предосудительного. Использование единого программного обеспечения для всех моделей позволяет обеспечить объективность сравнения, и Zhipu документирует использованные настройки. В любом случае, это заслуживает внимания. Заявления китайской модели с открытыми весами о рубежах оцениваются с помощью американского программного обеспечения для агентов, что говорит о положении инструментального уровня в этом соревновании то, чего не показывают оценки модели.
Прежде чем считать результаты CyberGym окончательными, следует обратить внимание на две дополнительные детали. Оценка представляет собой результат одного запуска, обозначенный как pass@1 по 1507 задачам, без указания дисперсии. Разница в семь десятых балла между двумя отдельными запусками – это не та разница, на которую следует полагаться. Кроме того, временные бюджеты ExploitGym были нормализованы с использованием показателей пропускной способности от Artificial Analysis, с коэффициентами масштабирования, указанными для GLM-5.3, Kimi K3 и Qwen3.8 Max, но не для Mythos 5.
Количество уязвимостей и число недостающих данных.
Помимо сравнительных тестов, компания Zhipu заявляет, что сотрудничала с группами специалистов по безопасности в Китае для проверки своих моделей на реальных кодовых базах, выявив 2436 уязвимостей в 269 проектах с открытым исходным кодом. Распределение по степени серьезности следующее: 107 критических, 990 высоких, 1286 средних и 53 низких. Самая старая уязвимость датируется 1981 годом, а в среднем уязвимость находилась в коде 26,6 лет до момента ее обнаружения.
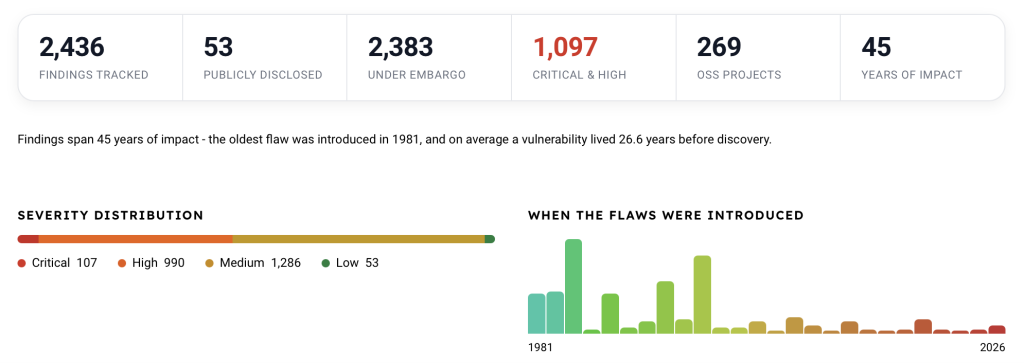
Одно несоответствие заслуживает внимательного рассмотрения. В сводной таблице Zhipu 1097 выявленных проблем обозначены как критические и высокие, что соответствует таблице степени серьезности. В основном тексте того же пресс-релиза эти 1097 проблем описаны как средние и высокие. Несколько изданий воспроизвели вторую версию.
Подсчет также проводится после того, что Чжипу описывает как экспертную проверку, отбор и удаление дубликатов, поэтому исходные данные модели не соответствуют тому, что сообщается. Из 2436 результатов 53 были обнародованы, а 2383 остаются под эмбарго. В пресс-релизе не указано, сколько из них были ранее неизвестны, и сколько были независимо воспроизведены. Именно эти две цифры превратили бы утверждение об объеме в утверждение о возможностях.
Что важнее, чем таблица результатов тестирования?
Два момента в пресс-релизе имеют более долгосрочные последствия, чем прибыль CyberGym.
Во-первых, это эффективность. Компания Zhipu сообщает, что GLM-5.3 достигает 31,4% эффективности в своем внутреннем тесте кода при обработке около 50 000 выходных токенов на задачу, в то время как Opus 4.8 показывает 29,5% эффективности при использовании 120 000 токенов. Незначительно улучшенные результаты при использовании менее половины токенов обусловлены экономическими соображениями, а стоимость определяет, могут ли команды безопасности, не обладающие большими бюджетами, вообще использовать эти инструменты.
Второй аспект — распространение. Чжипу утверждает, что весовые коэффициенты будут опубликованы после завершения оценки безопасности и повышения уровня защиты. Этого еще не произошло, и до тех пор, пока это не случится, утверждение об открытых весовых коэффициентах является скорее обязательством, чем фактом. Если это подтвердится, модель с документированной возможностью обнаружения уязвимостей станет чем-то, что любая команда сможет загрузить и запустить локально, в том числе на рынках, которые никогда не будут иметь доступа к американской модели, имеющей экспортный контроль.
Результаты взвешивания должны быть получены в конце августа.
См. также: Компания Anthropic вошла в Белый дом, и Mythos — причина, по которой Вашингтон впустил её.
Хотите узнать больше об искусственном интеллекте и больших данных от лидеров отрасли? Посетите выставку AI & Big Data Expo, которая пройдет в Амстердаме, Калифорнии и Лондоне. Это масштабное мероприятие является частью TechEx и проводится одновременно с другими ведущими технологическими выставками, включая Cyber Security & Cloud Expo. Для получения дополнительной информации нажмите здесь.
AI News — это проект TechForge Media. Здесь вы можете ознакомиться с другими предстоящими мероприятиями и вебинарами, посвященными корпоративным технологиям.
Источник: www.artificialintelligence-news.com
Оцените материал: