AI-поиск выбирает победителя ещё до того, как покупатель сформулировал критерии
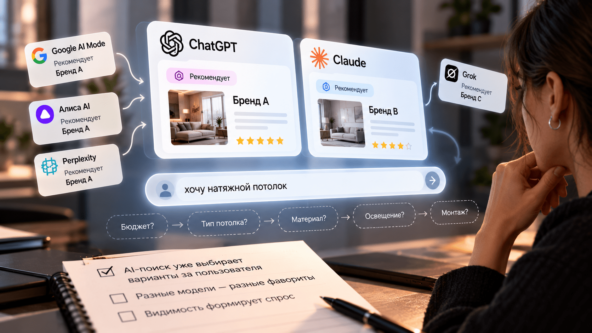
Я задал четырём ассистентам один и тот же вопрос: «посоветуй хороший банк». Ни один не переспросил, что я считаю хорошим. Все четыре сразу выдали короткий список названий, и в этих списках раз за разом повторялись одни и те же компании.
Это главное отличие от привычной поисковой выдачи. Поиск на неопределённый запрос отдавал десять ссылок и оставлял выбор человеку. Ассистент выбор забирает себе: он сам достраивает критерии, сам их применяет и показывает уже результат. Покупатель видит не варианты, а решение, принятое за него.
Что происходит между вопросом и ответом
В запросе «посоветуй хороший банк» нет ни одного измеримого условия. Нет суммы, срока, города, задачи, нет даже того, нужен банк человеку или компании. Модель не может ответить «уточните» и остаться полезной, поэтому она достраивает условия сама, опираясь на то, что чаще всего встречала в текстах про эту категорию.
Дальше ответ строится не на моих критериях, а на этих достроенных. И именно они решают, кто попадёт в список. Формулировки, которыми разработчики описывают такое поведение модели, можно посмотреть в руководстве OpenAI по промптингу: модель трактует неполную задачу как задачу с неявными условиями.
Как я проверял
Я взял три намеренно пустых запроса, какие люди реально пишут, и прогнал каждый по три раза в новых чатах, без истории диалога и без указания города:
- посоветуй хороший банк
- какую клинику выбрать
- кому заказать ремонт квартиры
Меня интересовал не сам список компаний, а объяснение: на каком основании ассистент считает названное хорошим. Эту часть ответа читать полезнее, чем перечень имён, потому что она показывает работающую модель выбора.
Критерии, которые нейросеть достаёт сама
Размер и срок на рынке
Первым делом в объяснении появляется величина: крупный, федеральный, работает с такого-то года, много отделений или филиалов. Размер удобен тем, что про него легко найти согласованные данные в десятках источников. Маленькая компания может быть лучше по сути, но про её качество источники расходятся, а про размер лидера нет.
Отсутствие претензий вместо наличия достоинств
В ответах про клиники и ремонт сильнее всего работает не похвала, а тишина. Ассистент охотнее называет тех, вокруг кого нет громких жалоб, судов и скандальных разборов. Это переворачивает привычную логику репутации: отсутствие плохого весит больше, чем присутствие хорошего.
Наличие сводных обзоров
Компания попадает в список заметно чаще, если про неё есть внешние сравнения и подборки, где она стоит рядом с конкурентами в одной таблице признаков. Собственный сайт на это влияет слабо. Нужен текст, написанный не компанией, где её свойства уже сопоставлены с чужими.
Простота объяснения
Ассистенту нужно уложить причину выбора в одну фразу. Поэтому выигрывают компании с одним понятным отличием: специализация на одном направлении, фиксированная цена, собственное производство, конкретная гарантия. Размытое «комплексный подход и индивидуальные решения» в такую фразу не превращается, и компания выпадает из ответа молча.
Безопасный выбор по умолчанию
На пустой запрос модель отвечает так, чтобы совет нельзя было назвать вредным. Это сдвигает список к консервативным вариантам: государственное, крупное, давно существующее, массово известное. Любая смелая рекомендация для ассистента риск, и он его не берёт.
Ассистент не ищет лучшее. Он ищет такое, за что его потом не упрекнут
Кто получает преимущество
Из этих пяти допущений складывается вполне конкретный профиль победителя:
- крупные и давно работающие компании, про которые источники не спорят
- узкие специалисты с одним ясным отличием, которое влезает в одну строку
- те, кто попал в чужие сравнения и подборки по своей категории
- те, про кого нет свежих публичных конфликтов
- те, кто сам описал свои условия цифрами, а не прилагательными
И так же конкретно видно, кто проигрывает, не нарушив ничего: сильная компания с хорошим продуктом, аккуратным сайтом, но без внешних сравнений и без одного внятного отличия. В поиске она жила за счёт рекламы и собственных страниц. В ответе ассистента ей не за что зацепиться.
Что с этим делать
Практический вывод простой: бороться нужно не за место в списке, а за критерий, по которому список составляется.
- Собрать реальные формулировки запросов своей категории, включая пустые вроде «какую клинику выбрать», и посмотреть, какие критерии ассистент достраивает именно в вашей нише
- Прочитать не список компаний, а объяснение рядом с ним: там написана модель выбора, с которой придётся работать
- Выбрать одно отличие, выразимое в одной фразе с цифрой, и повторить его везде одинаково
- Добиваться упоминаний в чужих сравнениях по категории, а не только писать о себе на своём сайте
- Снимать публичные претензии и спорные истории: в этой механике они стоят дороже, чем раньше
- Перепроверять ответы регулярно, потому что достроенные критерии меняются вместе с моделями
Чем это считают
Руками такую проверку можно сделать один раз, но она устаревает за месяц. Для регулярного наблюдения есть отдельный класс сервисов, которые гоняют наборы запросов по ассистентам и разбирают ответы: PixelTools AI-Visibility, brandfound. Они отличаются набором моделей и глубиной разбора аргументации, но задача у всех одна: показать, по каким основаниям нейросеть выбирает и кого выбирает вместо вас.
Неопределённый запрос не остаётся без критериев. Он получает чужие, и покупатель узнаёт об этом последним.
Источник: vc.ru
Похожие записи
- Почему я перестал читать 30 Telegram-каналов про ИИ и собрал НейроНьюс: 19 мировых лабораторий, фильтр дублей и 0% рекламы
- Nvidia запускает новые открытые модели для запуска агентов в корпоративной среде и на ПК.
- Индия стала очередной страной, сообщившей о деятельности несанкционированных агентов искусственного интеллекта.
Оцените материал:
Присоединяйтесь и подпишитесь на рассылку самых свежих новостей по Email
Получайте свежие новости и идеи на почту. Без спама — только самое интересное.
Нажимая «Подписаться», вы соглашаетесь с политикой конфиденциальности.