
Видео-модели генерируют всё более реалистичные интерактивные миры, но не…
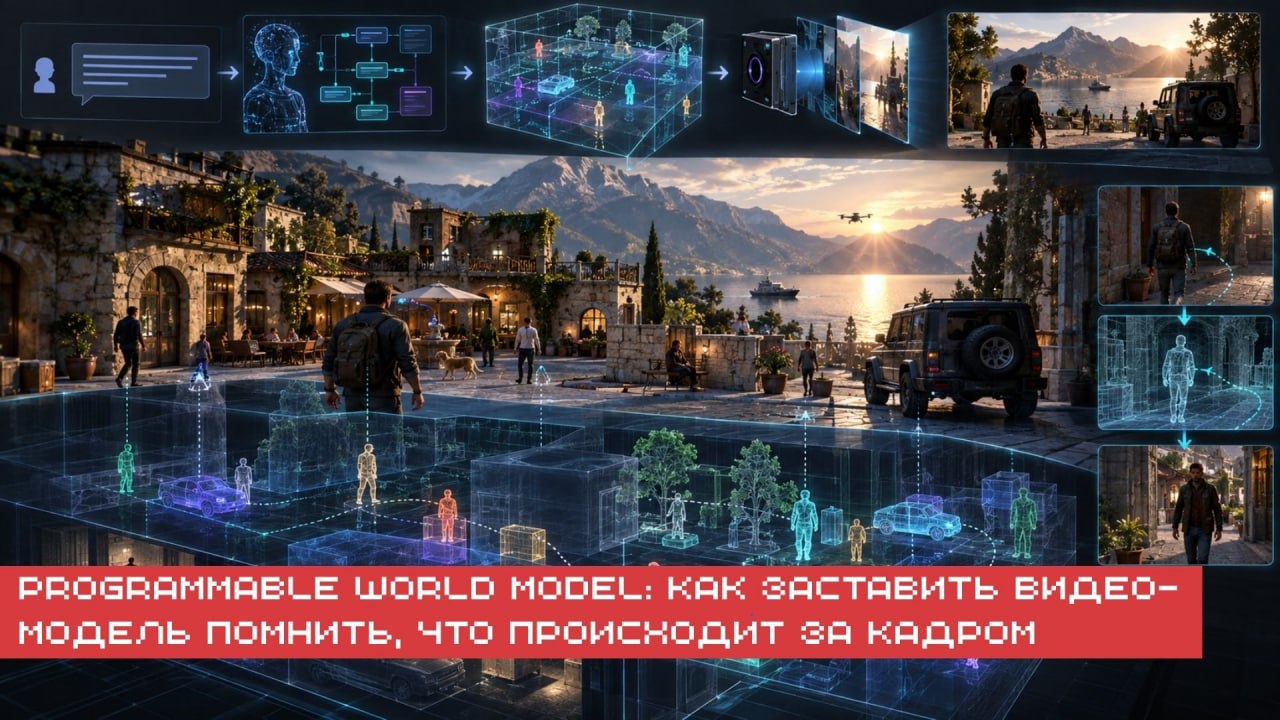
👁️ Видео-модели генерируют всё более реалистичные интерактивные миры, но не умеют удерживать состояние мира — если персонаж вышел за пределы кадра, модель забывает, что с ним происходило. Programmable World Model решает это разделением: отдельный слой явно хранит состояние всех сущностей, включая невидимые сейчас, а видео-модель отвечает только за рендеринг картинки.
Агент переводит инструкции на естественном языке в исполняемые программы с правилами переходов состояний, а лёгкий движок их выполняет и поддерживает персистентное состояние мира. Это состояние связывается с визуалом через промежуточное 3D-представление, которое детерминированно компилируется в сигналы для готовой видео-модели-рендерера.
👍 На собственном бенчмарке метод показал 94% точности подсчёта и 98% точности состояния, заметно обойдя существующие интерактивные видео-модели при сохранении связности на длинных горизонтах.
Та же логика, что мы видели в T1: не заставлять одну модель тащить всё на себе, а разделить явное состояние и генеративный слой поверх него.
Похожие записи
Оцените материал:
Похожие записи
Сделай своим ушкам больно❤️ Вы когда-нибудь задумывались, как звучит гиперскейлер?…
19.09.2026
Первый пошёл – китайский блогер с канала Mediastorm решил проверить…
19.09.2026
GPT-6 Astra во время обычной задачи начала писать себе манифест…
19.09.2026Присоединяйтесь и подпишитесь на рассылку самых свежих новостей по Email
Получайте свежие новости и идеи на почту. Без спама — только самое интересное.
Нажимая «Подписаться», вы соглашаетесь с политикой конфиденциальности.