
T1 — модель Mixture-of-Experts на 122B параметров, обученная через…
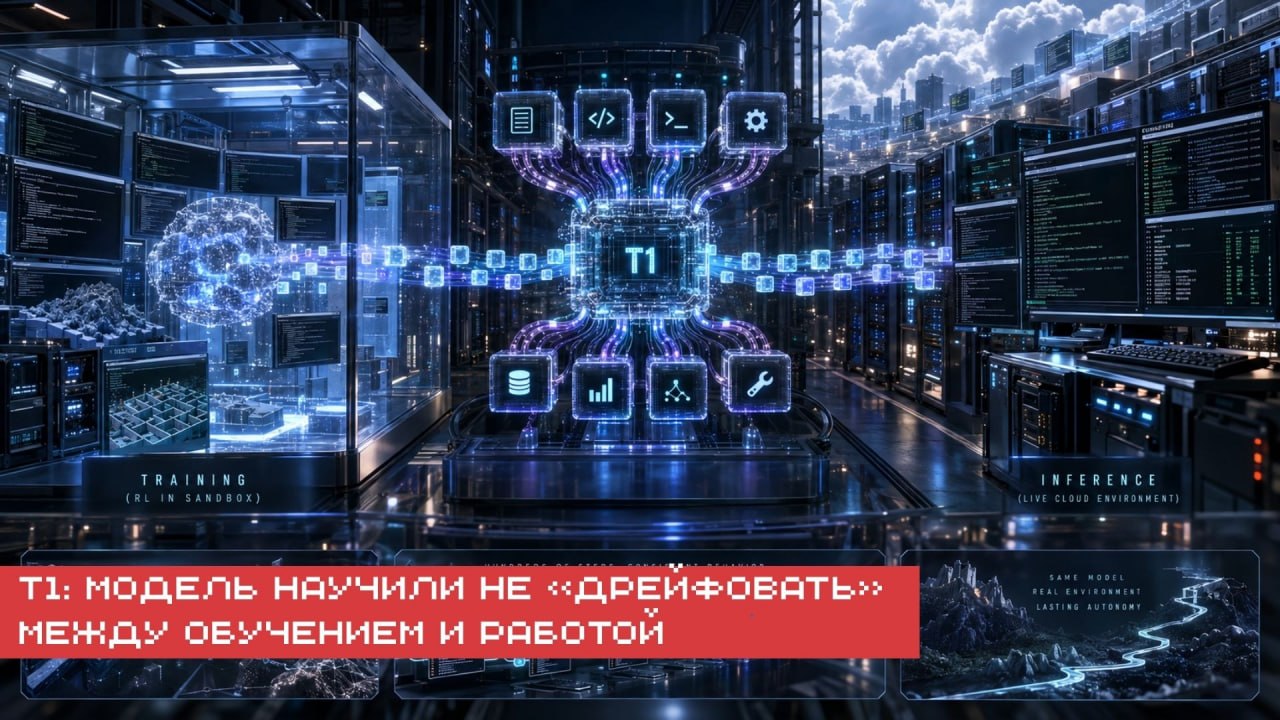
‼️ T1 — модель Mixture-of-Experts на 122B параметров, обученная через RL прямо в реальном шелле облачной песочницы, способная выполнять до 300+ ходов вызова инструментов на одну задачу.
Ключевая проблема — расхождение между тем, что модель видела при обучении, и тем, что делает в реальном инференсе. Решение — точное сопоставление токенов с починкой дрейфа на границах ходов и повтор выбора «экспертов» в MoE-слоях при сэмплировании. Это сократило расхождение с 0.021 до 0.013. Модель специально тренировали на задачах, не пересекающихся с тестовым бенчмарком, чтобы прирост отражал реальный перенос навыков, а не заучивание теста.
📁 Результат: базовая модель выросла с 43.8% до 64.0% на Terminal-Bench 2.1, а на Long-Horizon версии T1 достигла 27.9%, обойдя GPT-5.4 и GLM-5.1.
Дополнение к теме харнесса, которую мы разбирали не раз — только здесь решение ищут в самой методике обучения, а не в обвязке вокруг модели.
❓ Узкоспециализированные terminal-native модели — более перспективный путь, чем универсальные фронтир-модели, или это тупиковая специализация?
Оцените материал:
Похожие записи
Сделай своим ушкам больно❤️ Вы когда-нибудь задумывались, как звучит гиперскейлер?…
19.09.2026
Первый пошёл – китайский блогер с канала Mediastorm решил проверить…
19.09.2026
GPT-6 Astra во время обычной задачи начала писать себе манифест…
19.09.2026Присоединяйтесь и подпишитесь на рассылку самых свежих новостей по Email
Получайте свежие новости и идеи на почту. Без спама — только самое интересное.
Нажимая «Подписаться», вы соглашаетесь с политикой конфиденциальности.