
Улучшенное кэширование подсказок для GPT-6 | OpenAI
Более высокие показатели попадания в кэш и новые инструменты, помогающие постоянным агентам работать быстрее и дешевле.
- Мониторинг кэширования и диагностика промахов кэша.
- Оптимизируйте кэширование для вашего приложения.
- Начать
- Мониторинг кэширования и диагностика промахов кэша.
- Оптимизируйте кэширование для вашего приложения.
- Начать
GPT-6 позволяет постоянным агентам работать часами над сложными задачами, от рефакторинга кодовых баз до создания тщательно подготовленных документов и презентаций. Приложения, лежащие в основе этих агентов, отправляют серию запросов к API, которые основываются друг на друге, часто передавая те же инструкции, определения инструментов и контекст из предыдущих обращений. OpenAI кэширует этот общий контекст для повторного использования вычислений в разных запросах, сокращая время ответа и предоставляя разработчикам скидки до 90% на кэшированные входные токены.
В семействе GPT-6 мы внедрили улучшенную систему кэширования запросов, которая по умолчанию обеспечивает более высокие показатели попадания в кэш. Теперь мы предоставляем скидки на кэширование для соответствующих общих префиксов, повторно используемых в течение 30-минутного окна. Мы также представляем новые инструменты, которые помогут разработчикам отслеживать производительность кэша, диагностировать промахи и выбирать, какой объем запроса следует кэшировать.
« Кэширование запросов OpenAI играет решающую роль в обеспечении быстрой и эффективной работы GitHub Copilot в масштабах предприятия. За последние несколько месяцев нам удалось сократить более чем на 50% долю токенов запросов, требующих повторной обработки в миллиардах запросов к моделям OpenAI, по сравнению с нашим предыдущим базовым уровнем. В результате мы получили более эффективную систему вывода и более быстрое время получения первого ответа для разработчиков».
Мониторинг кэширования и диагностика промахов кэша.
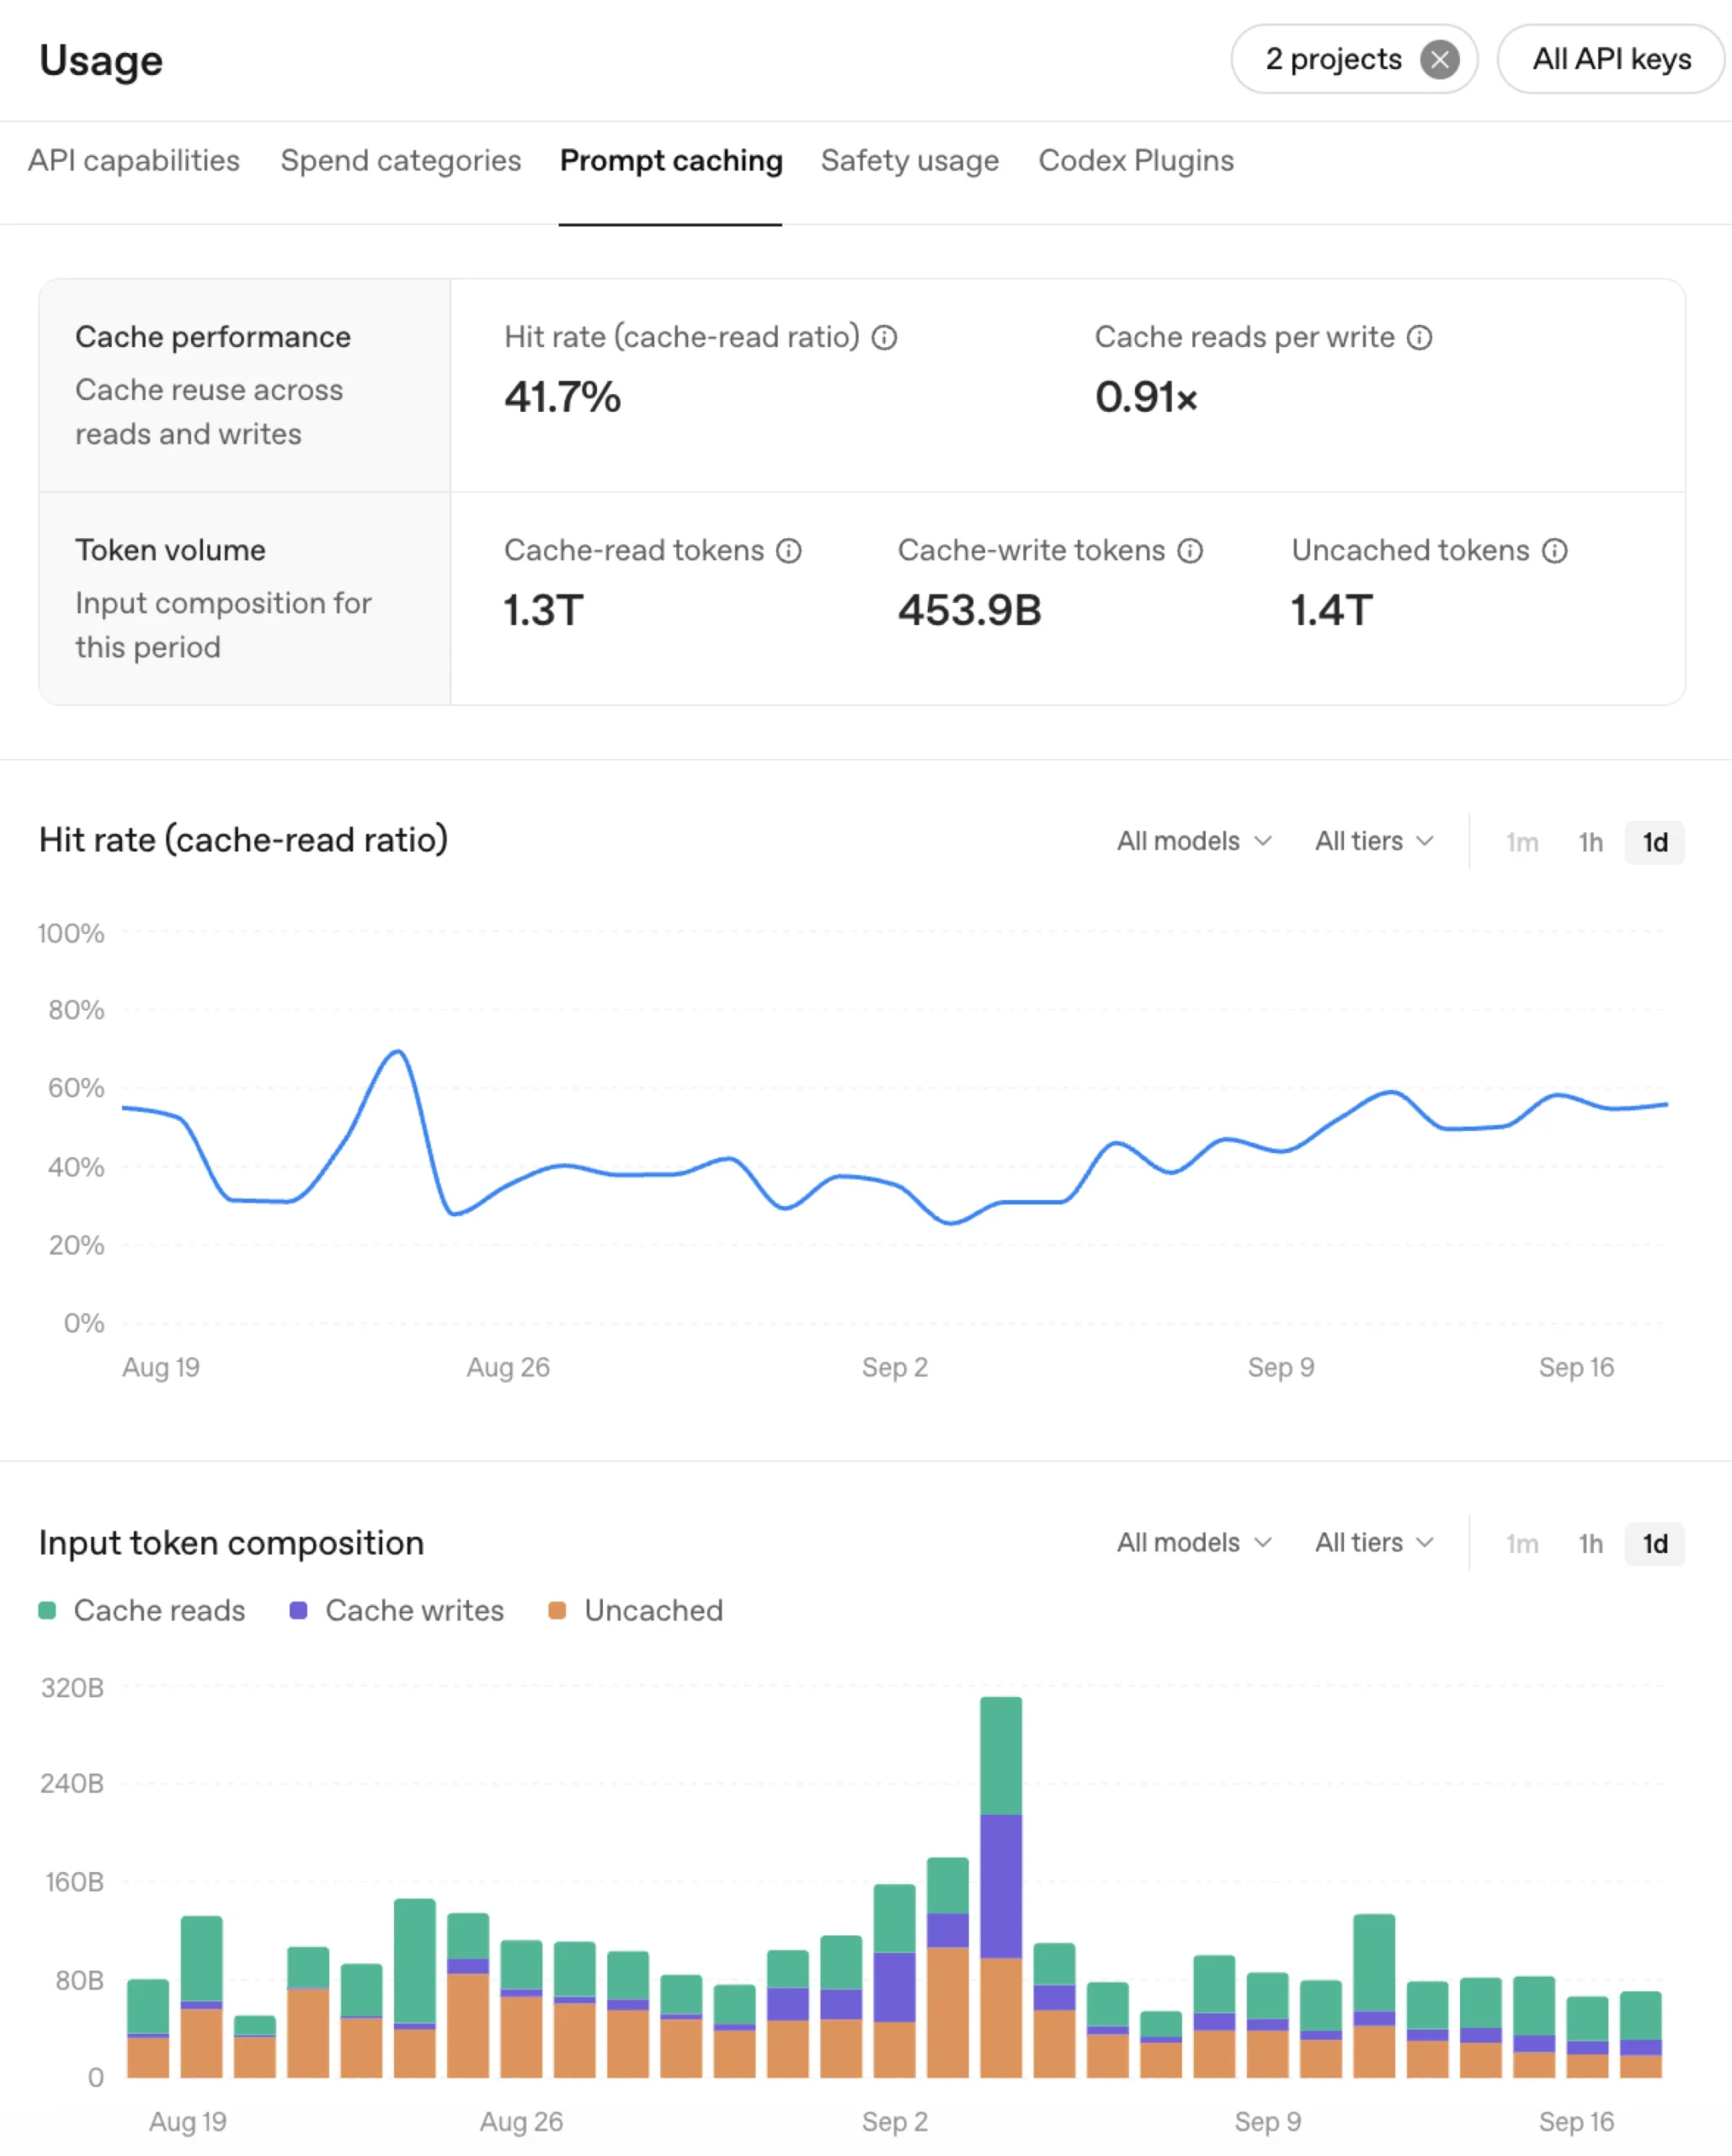
Новая панель мониторинга кэширования запросов (открывается в новом окне) показывает, какая часть входных данных вашего приложения обрабатывается из кэша. Отслеживайте показатели попаданий в кэш с течением времени и используйте диаграмму состава входных данных для сравнения кэшированных и некэшированных токенов. Эти представления помогут вам выявить снижение количества попаданий в кэш и оценить, как изменения в вашем приложении влияют на производительность кэширования.
При неожиданном промахе кэша воспользуйтесь инструментом диагностики кэширования ( откроется в новом окне), чтобы понять, что произошло. Сравните запрос с недавним ответом, чтобы выявить изменения в модели, инструментах, настройках или входных данных, которые препятствовали повторному использованию. Примерное количество затронутых токенов поможет вам оценить масштаб последствий и решить, как оптимизировать интеграцию для максимизации коэффициента попадания в кэш.
{ «prompt_cache_diagnostics»: { «type»: «cache_miss», «reason»: «tools_changed», «comparison_reusable_tokens»: 5629, «cache_missed_tokens»: 5629 } }
Оптимизируйте кэширование для вашего приложения.
Выберите, что кэшировать. Явные точки останова кэширования позволяют выбрать, какие префиксы подсказок использовать повторно. В обновленном руководстве по кэшированию подсказок (открывается в новом окне) объясняется, как их использовать, как долго кэшированные префиксы остаются доступными и как изменения в инструментах и входных данных влияют на их повторное использование.
Настройте сложность рассуждений без нарушения работы кэша. В моделях GPT-6 теперь можно изменять сложность рассуждений (открывается в новом окне) между ответами без нарушения работы кэша. Увеличьте сложность для более сложной задачи или уменьшите ее для рутинного последующего действия, добавив параметр configuration_update , оставив при этом сложность рассуждений на уровне запроса неизменной. Это позволяет регулировать объем рассуждений, необходимых для выполнения задачи, сохраняя при этом многократно используемый контекст.
Сохраняйте кэш по мере изменения инструментов и инструкций. По мере изменения потребностей вашего агента в использовании инструментов, поддерживайте стабильность определений инструментов, схем и порядка их применения, чтобы предыдущий контекст оставался пригодным для повторного использования. Используйте allowed_tools , чтобы сделать доступными только соответствующие инструменты, или установите tool_choice в значение none, если инструменты не требуются, вместо удаления определений. Используйте новые сообщения разработчика, чтобы добавлять новые инструкции в конец контекста и перезаписывать старые. См. наши рекомендации по управлению изменениями инструментов (открывается в новом окне) .
Предварительно прогрейте кэш, чтобы уменьшить задержку. Предварительная подготовка (открывается в новом окне) заранее подготавливает известный контекст, чтобы модель могла начать реагировать раньше, когда поступит запрос. Например, приложение может предварительно подготовить общие инструкции, определения инструментов или справочные материалы во время запуска, до того, как пользователь задаст свой первый вопрос. Это выводит обработку данных за пределы времени ожидания пользователя.
Эти дополнительные параметры управления расширяют возможности стандартного механизма кэширования, позволяя адаптировать его к вашей рабочей нагрузке.
1 из 3
« Диагностика кэширования запросов и панель мониторинга OpenAI помогли нам улучшить показатели попадания в кэш на несколько процентных пунктов, снизив затраты на 20%. Теперь мы получаем оповещения о неожиданных сбоях кэширования и используем агенты Codex для диагностики первопричины. Явные точки останова также позволяют нам кэшировать стабильный контекст, сохраняя при этом часто меняющийся контент в конце запроса. Это сделало экономически целесообразным создание форков для фоновых задач, при этом повторно используя почти весь общий контекст».
« Для долго работающих агентов, таких как Манус, надежное кэширование имеет фундаментальное значение с экономической точки зрения. Работая с командой инженеров OpenAI, мы усовершенствовали размещение точек останова в кэше, объединили явное и автоматическое кэширование и использовали реальные запросы для выявления неожиданных промахов кэша. Менее чем за неделю показатель попадания в кэш нашей модели OpenAI вырос с примерно 85% до стабильно превышающего 90%, что еще больше снизило затраты на вывод в производственной среде. Прогресс был достигнут благодаря ряду целенаправленных улучшений, и обе команды в процессе работы подтверждали полученные результаты».
« В сотрудничестве с OpenAI мы перевели наши агенты сеансов на явно заданные точки останова кэширования. Менее чем за неделю показатель попаданий в кэш в наших оценочных тестах вырос с 83% до 91%. Это означало меньшее количество записей в кэш и снижение затрат на вывод при той же рабочей нагрузке; количество записей в кэш сократилось примерно на две трети, а затраты на вывод — на 36%».
- Клубничный браузер
- Манус
- Мастер слова
Начать
- Отслеживайте показатели попаданий в кэш на панели мониторинга кэширования подсказок (откроется в новом окне) .
- Расследуйте неожиданные сбои с помощью диагностического инструмента (откроется в новом окне) .
- Следуйте руководству по кэшированию подсказок (открывается в новом окне) , чтобы улучшить свою настройку, или используйте Codex (открывается в новом окне), чтобы проверить свой код, внести улучшения и оценить результаты.
Источник: openai.com
Похожие записи
Оцените материал:
Похожие записи
Область исследований в переходный период: активаторы Т-клеток
24.09.2026
Anthropic сообщила об обнаружении новой ферментной системы с помощью ИИ-агентов Claude.
24.09.2026
Бенчмарк качества англо-русского перевода для ведущих западных и китайских LLM
24.09.2026Присоединяйтесь и подпишитесь на рассылку самых свежих новостей по Email
Получайте свежие новости и идеи на почту. Без спама — только самое интересное.
Нажимая «Подписаться», вы соглашаетесь с политикой конфиденциальности.