На пути к доказуемо приватному обучению на основе федеративных данных
Мы анонсируем новую систему федеративного обучения, которая обеспечивает внешне проверяемые гарантии конфиденциальности, перенося вычисления на сервер для повышения скорости обучения, точности и охвата устройств.
Быстрые ссылки
- Бумага
- Делиться
В 2017 году Google представила Federated Learning (FL) — технологию машинного обучения, которая обучает модели на децентрализованных, частных данных. Она используется для создания полезных функций, таких как прогнозирование следующего слова и функция Smart Compose в Gboard, подсказки для ответов в Google Messages и функция Smart Text Selection в Android.
Разработка наших систем FL руководствуется четырьмя основными принципами конфиденциальности: (1) минимизация данных, (2) анонимизация данных, (3) прозрачность и контроль, и (4) проверяемость и возможность аудита. Многолетние исследования в области анонимизации привели к надежным гарантиям дифференциальной конфиденциальности (DP) для производственных моделей с помощью таких алгоритмов, как матричная факторизация DP-FTRL (MF-DP-FTRL) и распределенная дифференциальная конфиденциальность в сочетании с безопасной агрегацией. В 2025 году мы представили усовершенствованное определение FL, основанное на этих четырех принципах:
Федеративное обучение (ФО) — это среда машинного обучения, в которой несколько субъектов (клиентов) сотрудничают в решении задачи машинного обучения под координацией поставщика услуг. Полноценная система ФО должна позволять клиентам сохранять полный контроль над своими данными, набором рабочих нагрузок, которым разрешен доступ к их данным, и свойствами анонимизации этих рабочих нагрузок. Системы ФО должны обеспечивать надлежащую прозрачность и контроль для пользователей, чьи данные управляются клиентами ФО.
В статье «К доказуемо конфиденциальному обучению на основе федеративных данных» мы объявляем о следующем поколении нашей системы федеративного обучения (FL), которая использует доверенные среды выполнения (TEE) для обеспечения полностью проверяемых и аудитируемых гарантий анонимизации данных. Логика, выполняемая в TEE, может быть удаленно подтверждена (третьи стороны могут проверить выполняемую логику), а также обеспечивает конфиденциальность (ее внутреннее состояние не может быть отслежено) и целостность (логика не может быть нарушена), с учетом ограничений TEE текущего поколения. Наша новая система FL на основе TEE развивает эти свойства, которые TEE предлагают на уровне одной машины, формируя полностью проверяемую сквозную систему FL, которая обеспечивает более надежные гарантии конфиденциальности и повышенную точность. Gboard уже внедрила новую систему и получает выгоду от значительно более быстрого времени вычислений по сравнению с нашей предыдущей системой FL.
Создание системы FL с возможностью проверки конфиденциальности на основе отдельных TEE.
Наша система федеративного анализа на основе TEE опирается на методы, разработанные в наших предыдущих работах по конфиденциальной федеративной аналитике и доказуемо конфиденциальной информации.
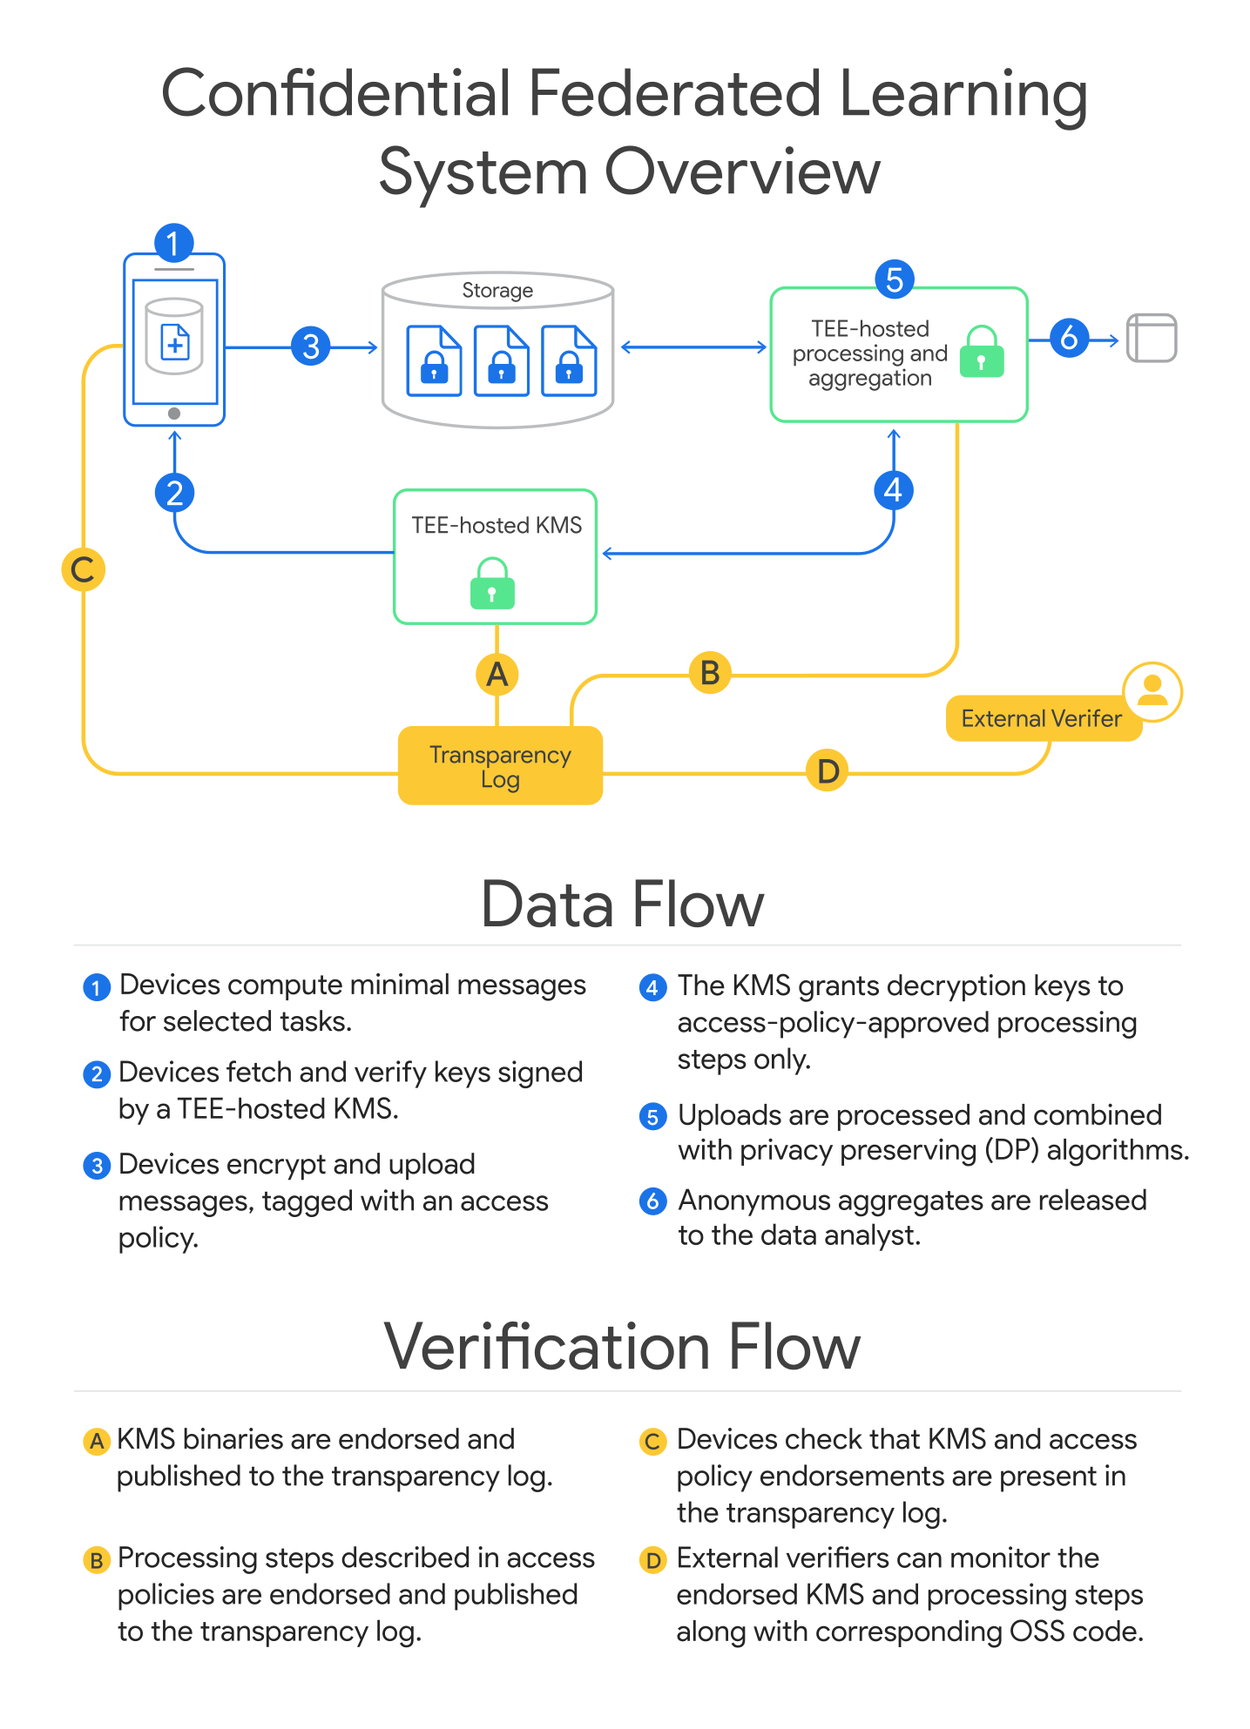
Система координирует четыре основных операционных концепции:
- Загрузка данных : Клиентские устройства локально шифруют обучающие примеры и загружают их. Устройства предварительно авторизуют политику доступа , которая представляет собой набор вычислений TEE, разрешенных для обработки этих данных, и эти вычисления выдают только анонимизированные результаты. Клиенты требуют публикации политик доступа в общедоступном журнале прозрачности.
- Система управления ключами ( KMS) и проверка политики : Система управления ключами (KMS), состоящая из кластера TEE, реализующих протокол консенсуса RAFT, выдает ключи дешифрования только тем рабочим нагрузкам TEE на стороне сервера, которые соответствуют вычислениям в политике доступа.
- Выполнение рабочей нагрузки : TEE для обработки данных выполняет программу на Python, реализующую цикл обучения. Этот «корневой» TEE делегирует параллельно выполняемые подзадачи кластеру рабочих TEE. Распределенная логика выражается с помощью Federated Language, языка оркестровки с открытым исходным кодом, не зависящего от фреймворка, созданного на основе TensorFlow Federated, который использовался в нашей предыдущей системе FL. Цикл обучения периодически передает анонимизированные веса модели аналитику данных.
- Отказоустойчивое восстановление : программа на Python сохраняет зашифрованное в KMS состояние восстановления в конце раунда обучения. Это можно использовать для восстановления после периодических сбоев root-прав или рабочих процессов без утечки какой-либо дополнительной конфиденциальной информации.
На этой диаграмме показан как поток данных через систему, так и шаги, необходимые для проверки гарантий конфиденциальности рабочих нагрузок, работающих в системе.
Более подробную информацию о проектировании системы федеративного обучения на основе TEE см. в нашем техническом документе «К доказуемо приватному обучению на основе федеративных данных».
Как TEE-основанное FL усиливает конфиденциальность
В более ранних системах FL данные с устройств загружались для немедленной агрегации, но у внешних наблюдателей не было возможности проверить, что данные никогда не регистрировались и не проверялись. Позже технология Secure Aggregation позволила криптографически защищать загружаемые данные, но оказалась несовместимой с современными централизованными гарантиями защиты данных. Наша новая система на основе TEE представляет собой следующий этап в наших постоянных усилиях по полному устранению необходимости доверять оператору сервера.
В нашей новой системе обучения на основе TEE операторам рабочих нагрузок доступны только метрики и веса модели с дифференциальной приватностью. Зашифрованные обучающие данные, собранные с устройств, могут быть расшифрованы и обработаны только внутри TEE, на которых запущены обучающие программы на Python, указанные в политиках доступа, и только в течение ограниченного времени после загрузки.
Журнал прозрачности и воспроизводимые сборки.
Устройства, участвующие в нашей новой системе FL на основе TEE, знают полный набор серверных нагрузок, которые могут получить доступ к загружаемым ими данным. Политики доступа, представляющие эти потенциальные будущие серверные нагрузки, публикуются в Rekor, общедоступном журнале прозрачности, и внешние аудиторы могут просматривать эти журналы, чтобы отслеживать полный набор серверных нагрузок, в которых потенциально могут участвовать устройства.
Используемые в нашей системе федеративных вычислений бинарные файлы KMS и обработки данных могут быть воспроизводимо собраны из открытого исходного кода, опубликованного в конфиденциальном репозитории Federated Compute на Github.
Проверяемое выполнение с динамической загрузкой из сторонних источников.
В наших более ранних системах FL логика, работающая на сервере, не могла быть проверена ни устройствами, ни аудиторами, поэтому нам нужно было, чтобы нам доверяли в вопросе правильного добавления случайного шума к суммам градиентов для обеспечения дифференциальной конфиденциальности.
В нашей новой системе обучения на основе TEE политики доступа, публикуемые в Rekor, напрямую описывают программу на Python, которая выражает логику обучения на основе обучения. Для защиты проприетарных архитектур моделей и логики предварительной обработки данных, а также для обеспечения возможности аудита, наши TEE для обработки данных поддерживают загрузку сериализованной информации в программу на Python во время выполнения. До тех пор, пока вся логика, имеющая отношение к конфиденциальности, остается жестко закодированной в программе на Python, эта функция загрузки позволяет запускать в TEE логику, которая должна оставаться проприетарной, обеспечивая при этом надежные внешне проверяемые гарантии конфиденциальности (см. ниже обсуждение наблюдений по побочным каналам).
Как Gboard использует язык программирования FL на основе TEE
Компания Gboard внедрила эту систему обучения английскому языку на основе TEE для запуска моделей прогнозирования следующего слова на английском и японском языках с более надежными гарантиями конфиденциальности и повышенной точностью. Эти улучшения можно объяснить несколькими аспектами новой конструкции системы.
Смягчение ограничений доступности в течение суток
Собирая все данные с устройств перед запуском серверной части программы обучения, нам больше не нужно беспокоиться о том, что суточные колебания доступности устройств повлияют на ход обучения. Во время выполнения на стороне сервера мы можем динамически рассчитывать оптимальный график участия устройств в программе и использовать его для настройки других параметров DP.
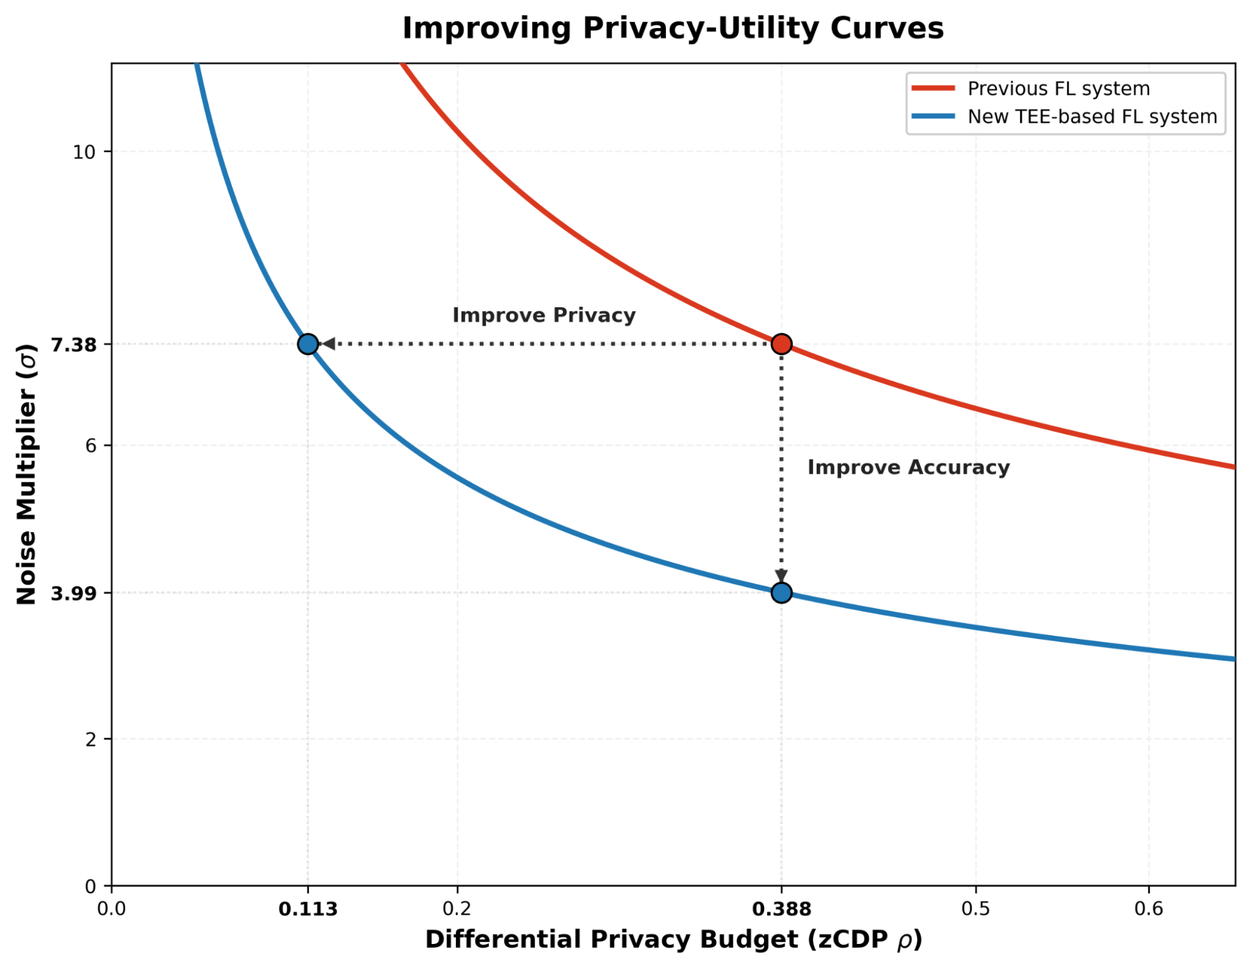
Этот график демонстрирует более надежные гарантии конфиденциальности и/или меньшие множители шума, которые становятся возможными благодаря новой системе на основе TEE за счет оптимизации графиков участия устройств. Эти кривые были получены в результате обучения модели прогнозирования следующего слова на английском языке в течение 5000 раундов с группами по 6500 устройств в обеих системах.
Ускорение обучения
Раньше обучение этих моделей FL могло занимать от 1 до 2 месяцев для каждой, при этом прогресс ограничивался доступностью устройств, вычислительными мощностями на устройствах и конкуренцией между несколькими рабочими нагрузками обучения за один и тот же набор ресурсов устройства. С новой системой на основе TEE узкие места переместились на сервер, а распараллеливание вычислений на множестве машин позволяет нам добиться значительного ускорения времени обучения, которое в настоящее время ограничено только доступностью ресурсов TEE.
Что дальше?
В нашей новой системе обучения с использованием TEE (Time-Executive Entity) вычисление градиентов на стороне клиента перенесено на сервер, что снимает ограничения, связанные с вычислительными ресурсами устройства, которые присутствовали в более ранних системах. Это открывает путь к обучению все более крупных моделей с использованием методов обучения с использованием TEE. Интеграция TEE с ускорителями будет играть важную роль в таких сценариях использования.
Описанная выше система способна выполнять не только задачи обучения FL-программ с возможностью проверки правильности выполнения, но и произвольные задачи, которые могут быть выражены с помощью Python. Мы экспериментируем с запуском других типов задач на этой инфраструктуре, таких как задачи генерации синтетических данных. Еще одно направление исследований: использование модулей обработки данных TEE, которые выполняют произвольные задачи Python, в сочетании с другими нашими модулями обработки данных TEE, специализирующимися на таких функциях, как вывод LLM-моделей.
Эта работа — шаг к строгому доказательству того, что обработка на стороне сервера обеспечивает конфиденциальность личных данных. Благодаря возможности внешних верификаторов точно проверить, какой код мы используем в Google, мы можем предоставить надежные гарантии того, что данные обрабатываются на стороне сервера именно так, как описано. Мы ожидаем, что будущее оборудование TEE, наряду с продолжающимися исследованиями по снижению риска получения данных по побочным каналам, обеспечит более надежную защиту динамически загружаемых рабочих нагрузок от вредоносных атак на стороне сервера. Мы предполагаем, что системы, подобные нашей, однажды смогут поставляться с полными доказательствами корректности программных реализаций алгоритмов DP и компонентов системы.
Благодарности
Авторы хотели бы поблагодарить сотрудников, внесших вклад в проектирование и внедрение инфраструктуры: Аруна Ганеша, Брендана Макмахана, Бретта Макларнона, Чуньсяна (Джейка) Чжэна, Эмили Гланц, Майю Спивак, Майкла Ренеера, Нову Фаллен, Стефана Дирауфа, Сусиня Го, Тимона Ван Овервельдта, Ю Сяо, Закари Чарльза и Закари Гарретта. Мы также благодарим близких партнеров, поддержавших интеграцию Gboard: Хайчэна Суна, Хенга Су, Цзяньпэна Хоу, Лияна Цзяна, Нориюки Такахаши, Вэньчжи Мао, Сяоцзюань Фан, Яньсяна Чжана, Инцзе Лю, Юаньбо Чжана и Юнь Вана. Эта работа была поддержана Коринной Кортес, Шумином Чжаем и Йосси Матиасом. Кроме того, мы благодарим Майсама Муссалема за отзывы по поводу написания этой статьи.
Источник: research.google
Оцените материал: