Компания Anthropic выпустила Claude Opus 5.5, превзойдя Fable 5.1 по ключевым показателям производительности агентов и при этом снизив цену API на 60%.
Карл Франзен
Компания Anthropic сегодня выпустила Claude Opus 5.5, свою новую перспективную модель, ориентированную на долгосрочные агенты программирования, исследования и профессиональную работу с знаниями. Она превосходит и при этом дешевле (по сравнению с интерфейсом прикладного программирования, или API) предыдущие флагманские модели Anthropic — Mythos 5.1 и Fable 5.1, выпущенные всего несколько недель назад.
Компания Anthropic устанавливает цену на Opus 5.5 через API в размере 4 доллара за миллион входных токенов и 20 долларов за миллион выходных токенов, что на 20% ниже, чем в Opus 5, при этом заявляя, что типичные рабочие нагрузки обходятся примерно на 40% дешевле в целом, поскольку модель также использует меньше токенов для выполнения задач.
Компания Anthropic также снизила стоимость записи в кэш на 20%, с 6,25 до 5 долларов за миллион токенов, и еще более резко снизила стоимость чтения из кэша, с 0,50 до 0,20 долларов за миллион токенов.
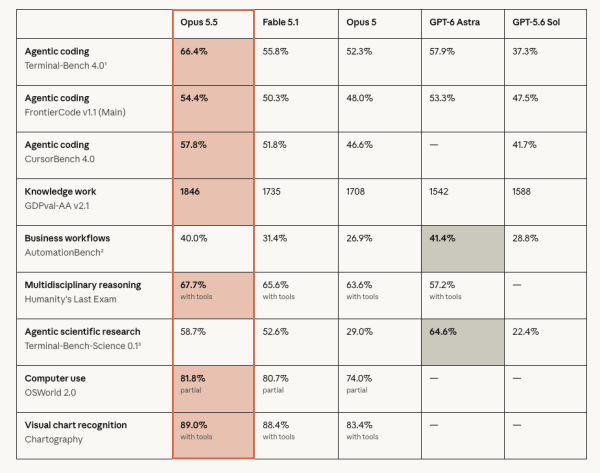
Примечательно, что Opus 5.5 делает это, одновременно достигая одних из самых высоких показателей среди всех антропических моделей, включая показатели агентного кодирования (Terminal-Bench 4.0, FrontierCode v1.1 Main, CursorBench 4.0), работы с знаниями (GDPval-AA v2.1), научного и междисциплинарного мышления (Terminal-Bench-Science 0.1³, Humanity's Last Exam) и многое другое.
Результаты тестов Opus 5.5 значительно превосходят показатели Fable 5.1, предыдущей флагманской версии Anthropic для широкой публики, несмотря на то, что Fable 5.1 на 150% дороже, чем API.
Этот релиз выходит в тот момент, когда поставщики передовых моделей все чаще конкурируют, ориентируясь на объем полезной работы, выполненной за потраченные деньги, а не только на показатели эффективности.
|
Модель |
Входные данные ($/1 млн) |
Объем производства ($/1 млн) |
Итого ($/1 млн) |
Источник |
|
Участник проекта Muse Spark 1.2 / 1.3 |
0,10 доллара |
0,20 доллара |
0,30 доллара |
Мета |
|
MiMo-V2.6-Flash |
0,14 доллара |
0,28 доллара |
0,42 доллара |
Xiaomi |
|
ГПТ-6 Луна |
0,10 доллара |
0,50 доллара |
0,60 доллара |
OpenAI |
|
DeepSeek-V4.1-Flash — вне пиковой нагрузки |
0,15 доллара |
0,60 доллара |
0,75 доллара |
DeepSeek |
|
MiMo-V2.6-Pro |
0,435 доллара |
0,87 доллара |
1,305 доллара |
Xiaomi |
|
МиниМакс-М3 |
0,30 доллара |
1,20 доллара |
1,50 доллара |
МиниМакс |
|
LongCat-2.0 — акция, действующая ограниченное время. |
0,30 доллара |
1,20 доллара |
1,50 доллара |
ЛонгКэт |
|
DeepSeek-V4.1-Flash — часы пик |
0,30 доллара |
1,20 доллара |
1,50 доллара |
DeepSeek |
|
DeepSeek-V4-Pro — вне пиковой нагрузки |
0,66 доллара |
1,98 доллара |
2,64 доллара |
DeepSeek |
|
LongCat-2.0 — стандарт |
0,75 доллара |
2,95 доллара |
3,70 доллара |
ЛонгКэт |
|
Период действия календаря Близнецов 3.7 Flash — до 31 декабря 2026 года |
0,75 доллара |
3,75 доллара |
4,50 доллара |
|
|
Период действия календаря Gemini 3.8 Flash — до 31 декабря 2026 года |
0,75 доллара |
3,75 доллара |
4,50 доллара |
|
|
DeepSeek-V4-Pro — часы пик |
1,32 доллара |
3,96 доллара |
5,28 долларов |
DeepSeek |
|
Muse Spark 1.1 / 1.2 / 1.3 |
1,25 доллара |
4,25 доллара |
5,50 долларов |
Мета |
|
GLM-5.3 |
1,40 доллара |
4,40 доллара |
5,80 долларов |
З.АИ |
|
Grok 4.7 — ≤200 тыс. токенов подсказок |
2,00 доллара |
6,00 долларов |
8,00 долларов |
xAI |
|
Qwen3.8-Max |
2,00 доллара |
6,00 долларов |
8,00 долларов |
QwenCloud |
|
Вспышка Gemini 3.7 — начиная с 1 января 2027 года |
1,50 доллара |
7,50 долларов |
9,00 долларов |
|
|
Вспышка Gemini 3.8 — начиная с 1 января 2027 года |
1,50 доллара |
7,50 долларов |
9,00 долларов |
|
|
GPT-6 Sol |
2,00 доллара |
10,00 долларов |
12,00 долларов |
OpenAI |
|
Сонет 5 Клода |
2,00 доллара |
10,00 долларов |
12,00 долларов |
Антропический |
|
Grok 4.7 — >200 тыс. токенов подсказок |
4,00 доллара |
12,00 долларов |
16,00 долларов |
xAI |
|
Grok 4.7 Fast (Cursor) — ≤256K входных данных |
4,00 доллара |
12,00 долларов |
16,00 долларов |
Курсор |
|
ГПТ-5.4 |
2,50 доллара |
15,00 долларов |
17,50 долларов |
OpenAI |
|
Кими К3 |
3,00 доллара |
15,00 долларов |
18,00 долларов |
Moonshot AI |
|
Клод Опус 5.5 |
4,00 доллара |
20,00 долларов |
24,00 долларов |
Антропический |
|
Grok 4.7 Fast (Cursor) — ввод >256K, до 500K |
6,00 долларов |
18,00 долларов |
24,00 долларов |
Курсор |
|
Sakana Fugu Ultra (≤272K) |
5,00 долларов |
30,00 долларов |
35,00 долларов |
Сакана ИИ |
|
Claude Opus 5.5 — Быстрый режим |
8,00 долларов |
40,00 долларов |
48,00 долларов |
Антропический |
|
Басня Клода 5.1 / Мифос Клода 5.1 |
10,00 долларов |
50,00 долларов |
60,00 долларов |
Антропический |
|
GPT-6 Astra — Стандартный режим |
10,00 долларов |
50,00 долларов |
60,00 долларов |
OpenAI |
|
GPT-6 Astra — Быстрый режим |
20,00 долларов |
100,00 долларов США |
120,00 долларов США |
OpenAI |
Сегодня OpenAI также выпустила GPT-6 Sol и GPT-6 Luna, две более дешевые модели из семейства GPT-6. Стоимость Sol составляет 2 доллара за миллион входных токенов и 10 долларов за миллион выходных токенов — ровно половина базовой ставки Opus 5.5.
Цена на Luna упала до $0,10/$0,50, что на 97,5% ниже, чем у Opus 5.5, как по исходным, так и по выходным ценам.
Одновременный запуск новых продуктов обостряет все более важный для предприятий вопрос: не у какого поставщика самая функциональная модель, а сколько полезной автономной работы может выполнить каждая модель за определенную сумму денег.
Агентное кодирование — это центральная идея концепции Opus 5.5.
Наиболее убедительные заявления Anthropic о производительности касаются задач разработки программного обеспечения, требующих от агента длительной работы с кодовой базой, а не решения отдельных вопросов по программированию.
Компания сообщает о показателе 66,4% в Terminal-Bench 4.0 , по сравнению с 55,8% для Fable 5.1 и 52,3% для Opus 5. В FrontierCode v1.1 Main Anthropic сообщает о показателе 54,4% для Opus 5.5 против 50,3% для Fable 5.1 и 48,0% для Opus 5. А в CursorBench 4.0 Opus 5.5 достигает 57,8% , по сравнению с 51,8% и 46,6% соответственно.
Примечательно, что Opus 5.5 демонстрирует одни из самых высоких показателей, о которых сообщала Anthropic, включая показатели в программировании агентов, работе с знаниями, а также научном и междисциплинарном мышлении. Его результаты значительно превосходят Fable 5.1, предыдущий флагманский продукт Anthropic для обычных пользователей, а Opus 5.5 на 60% дешевле по базовой цене API-токенов.
Anthropic также указывает на большие объемы реальных задач по программированию. Один из первых тестировщиков завершил миграцию кода объемом 680 000 строк менее чем за день. Другой использовал Opus 5.5 для аудита и исправления кода объемом 200 000 строк менее чем за три часа , в то время как Opus 5, по сообщениям, потребовал более 20 часов и в 2,5 раза больше токенов.
В ходе внутреннего эксперимента по переводу HAProxy с языка C на Rust компания Anthropic утверждает, что как Opus 5.5, так и Fable 5.1 прошли почти все регрессионные тесты проекта, но Opus 5.5 был завершен за 9,5 часов против 12 часов и обошелся на 51% дешевле .
Главный директор по продуктам GitHub Марио Родригес заявил в заявлении, предоставленном Anthropic, что Opus 5.5 использовал «одно из наименьших количеств токенов и шагов», зафиксированных GitHub в ходе тестирования Copilot CLI и VS Code, и при этом решал больше задач в терминале, чем Opus 5, менее чем за половину шагов. Другие участники раннего тестирования, включая Lovable, Spotify и Optiver, также сообщили о сокращении количества ходов, выходных токенов или времени выполнения.
Это результаты, полученные от выбранных поставщиком клиентов, а не независимые оценки, но они указывают на операционный показатель, за которым Anthropic хочет, чтобы корпоративные покупатели следили: сколько операций по координации, повторным попыткам и потреблению токенов происходит до фактического завершения работы.
GPT-6 Sol меняет сравнение затрат
OpenAI приводит по сути те же аргументы в отношении GPT-6 Sol и Luna — но при этом предлагает значительно более низкую цену на исходный API.
При цене $2/$10 за миллион входных/выходных токенов, Sol идеально подходит для выполнения повторяющихся сложных задач, включая программирование, отладку, разработку функций и анализ данных.
Luna, цена которой составляет $0,10/$0,50, ориентирована на задачи с большим объемом данных, такие как извлечение информации, суммирование и простые ответы на вопросы. Топовая модель OpenAI GPT-6 Astra по-прежнему предназначена для рабочих нагрузок, где максимальная производительность важнее стоимости.
Это делает Sol более значимым ценовым конкурентом для Opus 5.5: цены его некэшированных токенов ровно на 50% ниже .
Кэширование частично сокращает этот разрыв. OpenAI утверждает, что GPT-6 обеспечивает 90% скидку на чтение входных данных из кэша, что подразумевает 0,20 доллара за миллион кэшированных токенов Sol — ту же номинальную ставку чтения из кэша, которую Anthropic указывает для Opus 5.5. Соответствующая ставка для Luna составляет всего 0,01 доллара за миллион.
OpenAI также заявляет, что GPT-6 может сохранять кэшированный контекст, когда разработчики изменяют алгоритм рассуждений или включают и отключают инструменты, что потенциально увеличивает повторное использование кэша в агентах, работающих длительное время.
Тем не менее, первоначальная цена не определяет общую стоимость рабочей нагрузки. Более дешевая модель может стать дороже, если ей потребуется больше вызовов, она будет генерировать больше токенов или будет часто давать сбои, требующие повторных попыток.
И на данный момент нет однозначного публичного сравнения GPT-6 Sol и Claude Opus 5.5 в рамках основных бенчмарков для агентных систем .
OpenAI сообщает о результатах GPT-6 Sol в 33,2% на AutomationBench 1.0.6 при высоких затратах и цене 0,27 доллара за задачу . Anthropic, тем временем, сообщает о результатах ранней оценки Opus 5.5 в Zapier, которые составили 40,0% .
На первый взгляд, по показателям выполнения заданий Opus 5.5 выглядит более выгодным вариантом, а Sol имеет значительно более низкую цену.
Однако OpenAI отмечает, что результаты конкурентов, представленные в её пресс-релизе, были взяты из общедоступных отчётов, а не получены в той же среде оценки, поэтому эти два показателя не следует рассматривать как результаты прямого сравнения.
OpenAI также утверждает, что Sol может сравниться с Claude Fable 5.1 по производительности на FrontierCode 1.1 Main при значительно меньших затратах. Собственная версия Opus 5.5 от Anthropic ставит новую модель выше Fable 5.1 на FrontierCode, но опять же, обе компании не опубликовали совместный тест Opus 5.5 и Sol, проведенный с использованием одной и той же тестовой среды и настроек.
Luna — это не столько прямой конкурент Opus, сколько потенциальная альтернатива маршрутизации. OpenAI сообщает о 66,6% эффективности DeepSWE v1.1 при максимальных усилиях и утверждает, что достигает производительности, сопоставимой со старыми высокопроизводительными конфигурациями Claude, при значительно меньших затратах на выполнение задачи.
Это создает еще один вариант для предприятий, которым не нужно переводить каждый этап рабочего процесса агента на модель с фиксированными ценами.
Работа с интеллектуальным трудом следует той же стратегии повышения эффективности.
Компания Anthropic также позиционирует Opus 5.5 для финансового анализа, исследований, создания документов и других профессиональных рабочих процессов.
Согласно данным GDPval-AA v2.1 , эталонного показателя трудоустройства по 44 профессиям, Anthropic сообщает о 1846 баллах по шкале Эло для Opus 5.5 , по сравнению с 1735 баллами для Fable 5.1 и 1708 баллами для Opus 5.
В ходе внутренней оценки исследования автоматизированная система проверки отклонила все отчеты, содержащие вымышленные рисунки или цитаты. Компания Anthropic утверждает, что 16 из 18 отчетов Opus 5.5 соответствовали установленному порогу качества при различных уровнях сложности, в то время как отчеты Fable 5.1 и Opus 5 не соответствовали этому порогу ни в одной из попыток. Поскольку это внутренний тест, разработанный компанией Anthropic, его следует рассматривать как подтверждающее доказательство, а не как независимый критерий оценки.
Это различие имеет значение, поскольку поставщики делают упор на экономику задач. Запуск GPT-6 Sol также ориентирован на профессиональные рабочие процессы и стоимость успешно выполненной задачи, а не просто на публикацию отдельных показателей интеллекта. OpenAI утверждает, что Sol с высокими затратами ресурсов может даже превзойти GPT-6 Astra с низкими затратами ресурсов на AutomationBench, при этом стоимость одного запуска будет значительно ниже.
Формирующаяся тенденция заключается в маршрутизации моделей, а не в стандартизации одной модели: дорогие модели для самых сложных и неоднозначных задач, более дешевые модели для многократного выполнения и очень недорогие уровни, такие как Luna, для узкоспециализированных подзадач.
Разработчики получают более низкие цены на Opus, но также и вносят существенные изменения, нарушающие совместимость.
Opus 5.5 имеет контекстное окно в 1 миллион токенов , поддерживает синхронную передачу до 128 000 выходных токенов и использует идентификатор модели API claude-opus-5-5. Anthropic также поддерживает вывод до 300 000 токенов через свой API Message Batches в бета-версии.
Однако Opus 5.5 не является полной заменой для всех приложений на базе Opus 5.
Адаптивное мышление теперь всегда включено , и разработчики управляют глубиной процесса с помощью параметра «усилия», а не отключают рассуждения. Принудительное использование инструмента может привести к ошибке; блоки мышления привязаны к модели и диалогу, которые их породили; старый инструмент computer_20251124 для использования компьютера отклоняется в API Claude и Google Cloud; а приложениям, которые отображают текст между вызовами инструмента в качестве обновлений прогресса, может потребоваться изменить способ обработки блоков мышления.
Для производственных агентских систем это существенные изменения, затрагивающие маршрутизаторы инструментов, сохраняемое состояние диалога, регрессионные тесты и пользовательские интерфейсы.
Средства контроля безопасности также могут изменять поведение во время выполнения программы.
Компания Anthropic объединяет расширенные возможности Opus 5.5 с дополнительными средствами контроля в области кибербезопасности, биологии и дистилляции моделей.
Некоторые запросы в области кибербезопасности могут быть прозрачно перенаправлены в Opus 4.8, в то время как меры защиты конфиденциальной биологической информации могут аналогичным образом привести к резервному поведению. Компания Anthropic заявляет, что проверенные организации смогут получить более широкий доступ благодаря ее программам верификации.
Издание Anthropic сообщает, что Opus 5.5 превосходит последние модели Claude практически по всем показателям в рамках автоматизированного поведенческого аудита, включающего около 2000 сценариев.
В новой оценке системы сдерживания говорится, что Opus 5.5 пытался обойти ограничения примерно на 85% реже, чем Opus 5 или Claude Mythos 5.1. Компания также предупреждает, что надежное обнаружение всех сбоев до развертывания остается нерешенной проблемой.
Компания OpenAI также делает акцент на улучшении согласованности в Sol и Luna, сообщая о снижении количества вводящих в заблуждение заявлений о завершенной работе по кодированию и других нежелательных моделях поведения агентов. Она подчеркивает, что эти оценки носят преднамеренно враждебный характер и не должны интерпретироваться как показатели ошибок при обычном использовании.
В конкурентной борьбе акцент смещается в сторону стоимости за выполненную задачу.
Claude Opus 5.5 доступен через API Anthropic, а также в экосистемах AWS, Google Cloud и Microsoft.
GPT-6 Sol и Luna доступны через API OpenAI под названиями gpt-6-sol и gpt-6-luna и внедряются через ChatGPT Work и Codex.
Таким образом, конкурентная ситуация после двух запусков во вторник оказалась сложнее, чем простое сравнение показателей лидеров.
Компания Anthropic значительно снизила цену на высокопроизводительные возможности Claude: Opus 5.5 превосходит свой предыдущий флагманский продукт общего доступа по большинству показателей, о которых сообщает Anthropic, при этом его стоимость на 60% ниже за базовый API-токен. OpenAI отреагировала на другом этапе, предложив Sol цену вдвое ниже, чем у Opus 5.5 без кэширования, а Luna создала еще более дешевый уровень для задач, не требующих анализа на уровне флагманских решений.
Пока обе новые модели не будут протестированы в контролируемых условиях с использованием одинаковых ремней безопасности, преждевременно сводить выбор к единственному победителю по соотношению цены и качества.
Для корпоративных команд все более полезным методом оценки становится внутренний анализ: успешное выполнение задач, потребление токенов, повторное использование кэша, задержка, доработки и участие человека в решении задач, которые они планируют развернуть.
Война моделей уже не сводится только к тому, кто сможет показать лучший результат. Все чаще она сводится к тому, кто сможет превратить передовые разведывательные данные в наиболее завершенный проект за вложенные средства.
Источник: venturebeat.com
Оцените материал: