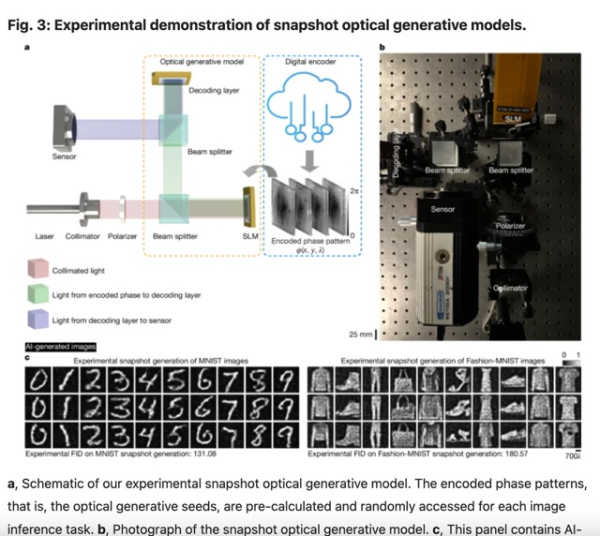
Команда UCLA создала оптическую генеративную модель, которая работает на свете, а не на GPU
В демонстрации шум сначала кодируется в фазовые паттерны с помощью лёгкого энкодера, а затем свободное распространение света (оптический декодер) превращает их в изображения, цифры, одежду, бабочек, лица и даже картины в стиле Ван Гога.
Главное — во время генерации нет никакой вычислительной нагрузки.
Результаты сопоставимы с цифровыми диффузионными моделями и открывают путь к сверхбыстрому и энергоэффективному ИИ на фотонике.
Paper (Nature): https://nature.com/articles/s41586-025-09446-5#MOESM1
Источник: nature.com
Источник: ai-news.ru
Похожие записи
- Переводчик с тимлидского: что слышит команда, когда вы говорите «внедряем ИИ‑агентов»
- Команда использует AlphaFold AI для перепроектирования белков, используемых для редактирования генов, чтобы сделать их более безопасными.
- Супердорогая новая команда искусственного интеллекта Меты уже стала полной катастрофой
Оцените материал:
Похожие записи
Платформа для разработчиков Railway призывает «всех пользователей» отозвать секретные ключи после кибератаки.
22.10.2026
Как написать промпт для картинок в ChatGPT: инструкция и примеры
22.10.2026
Искали кобальт, нашли уран. Как пять тысяч тонн урана могли незаметно попасть в цепочку поставок
22.10.2026Присоединяйтесь и подпишитесь на рассылку самых свежих новостей по Email
Получайте свежие новости и идеи на почту. Без спама — только самое интересное.
Нажимая «Подписаться», вы соглашаетесь с политикой конфиденциальности.