AI Review кода за 30 минут: локальная LLM прямо в CI/CD
Вступление
В этой статье я покажу, как всего за 30 минут подключить автоматическое AI-ревью кода в вашем проекте — бесплатно, без токенов, без OpenAI и полностью локально.
В основе решения — три компонента: Ollama, AI Review и GitHub Actions. Ollama отвечает за запуск локальной LLM прямо внутри CI/CD без интернета и внешних API. AI Review — опенсорсный инструмент, который анализирует изменения в Pull Request и оставляет комментарии прямо в GitHub. GitHub Actions обеспечивает автоматический запуск ревью при каждом изменении кода.
Система работает полностью изолированно: код никогда не покидает репозиторий, данные не отправляются во внешние сервисы (OpenAI, Claude, Gemini), а результат формируется локальной моделью в виде inline-комментариев и summary-отчёта.
Иными словами, вы получаете тот же уровень «умного ревью», что и в облачных решениях, но без платы, VPN и рисков для безопасности. В качестве LLM мы будем использовать Ollama, а анализ кода выполнит AI Review, о котором я подробно рассказывал в предыдущей статье. Тот же подход можно адаптировать под GitLab, Bitbucket или Jenkins — всё кроссплатформенно и не привязано к конкретному CI.
Что такое Ollama и зачем она нужна?
Когда речь заходит об AI-ревью, первый вопрос — на какой LLM оно будет работать. Обычно разработчики вспоминают OpenAI, Claude или Gemini. Но у таких решений есть три очевидных минуса: они стоят денег, недоступны в ряде стран (РФ, РБ), и требуют отправки кода во внешние сервисы.
Теперь представьте, что ту же модель можно запустить прямо внутри CI/CD — без токенов, VPN и передачи данных наружу. Вот здесь и появляется Ollama. Это не альтернатива OpenAI, а удобный локальный адаптер, позволяющий разворачивать модели вроде llama3, phi3, mistral, codellama и других в один Docker-контейнер и обращаться к ним через HTTP API.
Для AI Review это идеальное решение: инструмент не зависит от конкретного провайдера, поддерживает любую модель — от «тяжёлых» GPT-уровня до лёгких локальных — и при необходимости легко переключается на свой LLM endpoint.
Хотите локально — ставьте Ollama, нужно в облаке — подключайте OpenAI, Claude или собственный inference-сервер. AI Review универсален по дизайну и одинаково хорошо работает в CI, на сервере или в корпоративной сети без выхода в интернет.
Настраиваем AI Review
Чтобы запустить ревью, достаточно минимального конфига. AI Review из коробки поддерживает GitHub и умеет анализировать Pull Request без дополнительной настройки. Всё сводится к нескольким строкам YAML — можно просто положить файл в корень проекта.
Создаём .ai-review.yaml:
# Используем локальную LLM через Ollama llm: provider: OLLAMA meta: model: mistral # модель, которую будет использовать ревью max_tokens: 2048 # ограничение на размер ответа temperature: 0.2 # чем ниже, тем строже ответы http_client: api_url: http://localhost:11434 # локальный endpoint Ollama timeout: 600 # запас по времени для генерации # Подключаемся к GitHub для получения PR и публикации комментариев vcs: provider: GITHUB http_client: api_url: https://api.github.com timeout: 120
И всё — AI Review подключится к локальной модели через Ollama и начнёт анализировать изменения в вашем PR.
Если хотите добавить собственные промпты, изменить стиль комментариев, ограничить количество замечаний или исключить файлы из анализа — всё это настраивается в расширенном конфиге. Подробности — в документации AI Review.
Настраиваем GitHub Actions
Теперь добавим пайплайн, который будет запускать ревью в CI/CD. Всё просто: создаём файл .github/workflows/ai-review.yml. Он поднимает Ollama, скачивает модель, прогревает её и запускает AI Review.
Для других CI (GitLab, Bitbucket, Jenkins) всё аналогично — нужно лишь поднять контейнер Ollama и вызвать CLI-команду ai-review run.
Создаём .github/workflows/ai-review.yml:
name: 🤖 AI Review on: # Ручной запуск пайплайна (можно заменить на on: pull_request) workflow_dispatch: inputs: review-command: type: choice default: «run» options: [ run, run-inline, run-context, run-summary ] description: «Какой тип ревью запустить» pull-request-number: type: string required: true description: «Номер Pull Request» jobs: ai-review: name: Run AI Review runs-on: ubuntu-latest # Поднимаем локальную LLM Ollama в фоне services: ollama: image: ollama/ollama:latest ports: [ 11434:11434 ] steps: # 1️⃣ Клонируем репозиторий — name: 🧱 Checkout repository uses: actions/checkout@v4 with: fetch-depth: 0 # нужно, чтобы видеть diff в PR # 2️⃣ Ждём, пока Ollama поднимется — name: ⏳ Wait for Ollama to start run: | echo «⏳ Ожидаем запуск Ollama…» for i in $(seq 1 30); do if curl -s http://localhost:11434/api/version; then echo «✅ Ollama готова!» break fi sleep 3 done # 3️⃣ Скачиваем выбранную модель (в примере — mistral) — name: 📦 Pull model run: | echo «📥 Загружаем модель ‘mistral’…» curl -X POST http://localhost:11434/api/pull -H «Content-Type: application/json» -d ‘{«model»: «mistral»}’ # 4️⃣ Прогреваем модель (чтобы первый запрос не был долгим) — name: 🔥 Warm up model run: | echo «🔥 Прогреваем модель…» curl -s -X POST http://localhost:11434/api/chat -H «Content-Type: application/json» -d ‘{«model»:»mistral»,»stream»:false,»messages»:[{«role»:»user»,»content»:»Hello!»}]}’ echo «✅ Warm-up complete.» # 5️⃣ Запускаем ревью — name: 🚀 Run AI Review # Укажите актуальную версию инструмента uses: Nikita-Filonov/ai-review@v0.27.0 env: # GitHub токен для доступа к PR VCS__HTTP_CLIENT__API_TOKEN: ${{ secrets.GITHUB_TOKEN }} # Контекст PR (репозиторий и номер) VCS__PIPELINE__OWNER: ${{ github.repository_owner }} VCS__PIPELINE__REPO: ${{ github.event.repository.name }} VCS__PIPELINE__PULL_NUMBER: ${{ inputs.pull-request-number }} with: # Тип запускаемого ревью: полный, только inline или summary review-command: ${{ inputs.review-command }}
Если вы используете GitLab CI, Jenkins или Bitbucket Pipelines — просто повторите те же шаги: запустите Ollama в контейнере, скачайте модель и вызовите CLI-команду ai-review run с нужными переменными окружения.
Результат
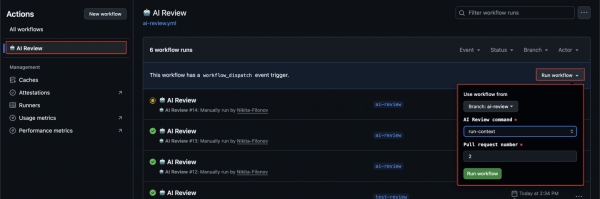
После настройки всего пайплайна можно запустить ревью вручную — достаточно выбрать команду (run, run-inline, run-context, run-summary) и указать номер Pull Request. Это делается прямо из вкладки Actions → AI Review → Run workflow:
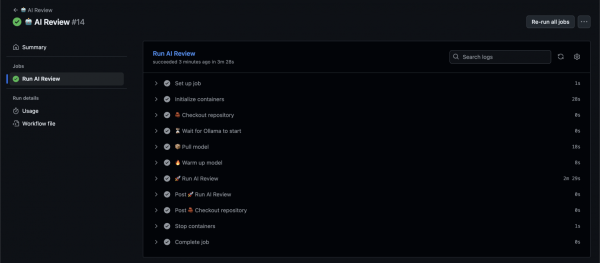
После старта GitHub Actions поднимает контейнер с Ollama, скачивает выбранную модель (в нашем примере — mistral), прогревает её и запускает AI Review. В логах можно видеть все шаги пайплайна — от инициализации контейнера до публикации комментариев:
-
Пример пайплайна context review
-
Пример пайплайна summary review
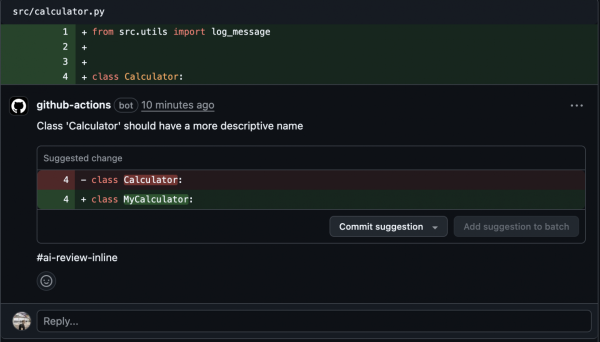
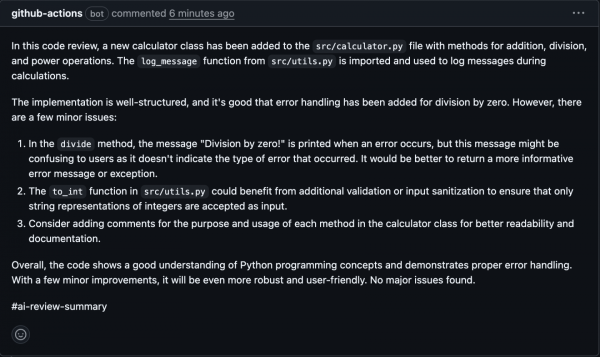
Через пару минут в самом Pull Request появятся комментарии от GitHub Actions:
Inline-комментарии — конкретные замечания по строкам кода:
Summary-комментарий — общий обзор изменений и рекомендации:
Важно: чтобы бот мог публиковать комментарии, убедитесь, что GITHUB_TOKEN имеет права read + write для Pull Request. Это можно включить в настройках репозитория или явно указать в workflow.
Есть нюанс
Нужно понимать: Ollama — это не облачный OpenAI, и на CI/CD с ограниченными ресурсами она может работать заметно медленнее. Скорость генерации напрямую зависит от самой модели, длины промптов и количества токенов в ответе.
В базовой конфигурации из статьи ревью может занимать от 1 до 3 минут на файл, и это нормально для локального запуска без GPU. Если хочется ближе к облачному опыту — просто перенесите Ollama на:
-
отдельный self-hosted runner с выделенными ресурсами;
-
или облачную виртуалку (4+ CPU, 8+ GB RAM — минимально комфортно);
-
или GPU-инстанс, если используете крупные модели вроде llama3 или codellama.
Важно понимать: AI Review не тормозит сам по себе — его скорость полностью зависит от LLM-провайдера, к которому вы подключены. Сегодня это Ollama, завтра может быть OpenAI, Claude, Gemini или даже ваш внутренний inference-сервер. Интерфейс и логика работы останутся теми же.
Главная идея — гибкость и автономность, а не “чудо за бесплатно”. Этот пример показывает, что можно построить AI Review, не отдавая код вовне и не платя за токены. А вот как быстро и на какой модели — зависит уже от выбранного стека и ваших ресурсов.
Заключение
В итоге мы получили полноценный AI code review, работающий прямо в CI/CD — без токенов, без внешних API и без копейки затрат. AI Review анализирует Pull Request, оставляет inline-комментарии, формирует summary — и всё это происходит внутри вашей инфраструктуры, без передачи кода наружу.
По сути, всё, что нужно — это Docker, GitHub Actions и минимальный конфиг. Дальше вы сами решаете, как масштабировать решение: оставить базовый сценарий на GitHub или развернуть Ollama на self-hosted runner или облачном сервере с подходящими ресурсами.
Важно понимать: в мире, где OpenAI, Claude или Gemini стоят денег, требуют VPN и не всегда доступны, локальные решения — это не компромисс, а альтернатива. Они дают ту же пользу — помогают команде писать чище, быстрее и увереннее — но делают это безопасно и доступно каждому.
При этом решение не требует токенов, VPN или внешних зависимостей — всё можно запустить локально, в изолированной среде. А если в будущем появится необходимость — вы всегда сможете подключить другую LLM, будь то OpenAI, Claude, Gemini или собственный корпоративный inference-сервер.
Полезные ссылки и демо
Чтобы не тратить время на поиски — вот всё, что нужно для повторения примера и вдохновения:
-
AI Review — опенсорсный инструмент для автоматического анализа кода и ревью изменений. Поддерживает GitHub, GitLab, Bitbucket и другие CI/CD-платформы, а также совместим с большинством популярных LLM-провайдеров — OpenAI, Claude, Gemini, Ollama.
-
Пример Pull Request с комментариями от AI Review (inline + summary)
-
Пример GitHub Actions pipeline (Ollama + AI Review)
-
Минимальный конфиг .ai-review.yaml для запуска из коробки
-
Подробная документация по настройке промптов, фильтров и расширенной конфигурации
Если статья оказалась полезной — поставьте звёздочку репозиторию AI Review на GitHub. Это поможет проекту развиваться и оставаться полностью бесплатным и опенсорсным.
Источник: habr.com
Оцените материал: