Как я учил AI-ассистента готовить дейлики и планировать встречи
Я собрал Teamsy, ассистента для подготовки командных встреч, ведения заметок и планирования 1:1. Первый бриф он выдал с третьей попытки за 45 минут, перепутал авторов действий и пропустил важные темы. Рассказываю, как я разбирал эти ошибки, что передал скриптам и какую работу оставил себе.
Почему я решил изменить дейлик
У меня три команды, всего 12 человек, и на дейлик мы собирались вместе. Встреча шла по старинке: открывали канбан-доски и проходили по задачам справа налево, сверху вниз. Каждый по очереди пояснял, что происходит с его задачами. Дейлик затягивался на час, и половина участников уже засыпала, пока предыдущие рассказывали про свои карточки.
Мне хотелось обсуждать на дейлике препятствия и вопросы, требующие участия команды. Чтобы подготовить такую повестку, перед встречей я открывал трекер задач, систему с кодом и рабочие чаты. Проверял, что изменилось со вчерашнего дня, где застряло ревью и о чем мы договорились на прошлом созвоне.
На такую подготовку уходил еще час. Хотелось тратить это время на людей и сложные вопросы, а сбор фактов поручить ассистенту.
Для этого я собрал Teamsy и специально оформил его как плагин, который устанавливается одной командой. Я поделился им с коллегами в компании, чтобы они тоже могли пользоваться ассистентом, добавлять свои сценарии и дорабатывать его.
Teamsy работает с файлами в рабочей папке тимлида. Там хранятся настройки команды, выгрузки из рабочих систем, заметки и готовые брифы. Сам плагин содержит инструкции и скрипты: агент читает нужные данные, запускает обработку и сохраняет результат. Я начал с дейликов, ретроспектив и заметок, а затем добавил планирование встреч.
Для работы с командными встречами я добавил интеграцию с RetroPoint, моим сервисом для ретроспектив и других командных встреч. Teamsy читает оттуда прошлые договоренности, записывает повестки и заполняет протоколы по участникам. Так я использую собственный сервис в ежедневной работе команды и вижу, чего не хватает для работы с AI-ассистентом.
Для дейлика мне нужна была повестка на 25 минут вокруг конкретных препятствий: зависшего ревью, спора в обсуждении кода, зависимости от соседней команды или пропущенного срока. Сведения о том, кто что делал, можно заранее собрать в протокол по участникам. На встрече я хотел оставить больше времени для вопросов, которые требуют общего обсуждения.
Первый бриф пришлось разбирать по фактам
Я проверял Teamsy в Claude Code и в более простом агенте уровня Qwen Code. Оба могли обращаться к рабочим системам и запускать скрипты, но с одними и теми же инструкциями справлялись по-разному.
В одном клиенте первый бриф получился только с третьей попытки. На все ушло 45 минут. Два предыдущих запуска оборвались: промежуточный сервис, через который шли запросы к модели, прерывал ответ, если его генерация занимала больше 120 секунд. Контекст сессии к тому моменту вырос примерно до 150 тысяч токенов, единиц текста, которые обрабатывает модель. Агент успевал собрать большой объем данных, а дописать документ одним ответом уже не мог.
В готовом тексте нашлись ошибки. В четырех случаях ассистент приписал действия не тем людям. Например, статус задачи поменял один сотрудник, а в протоколе это действие оказалось у назначенного исполнителя.
Из шести тем, которые нашел второй агент, первый пропустил четыре. Во всех четырех нужно было понять спор в комментариях к задаче или изменениям кода.
При этом сроки и время прохождения задач он посчитал аккуратнее, чем мы на живой встрече. В одном брифе соседствовали полезные расчеты и неверные выводы о работе людей. Поэтому проверять только связность текста было недостаточно.
Что я передал скриптам
После первых прогонов я стал выносить в код все, что можно определить по явным правилам.
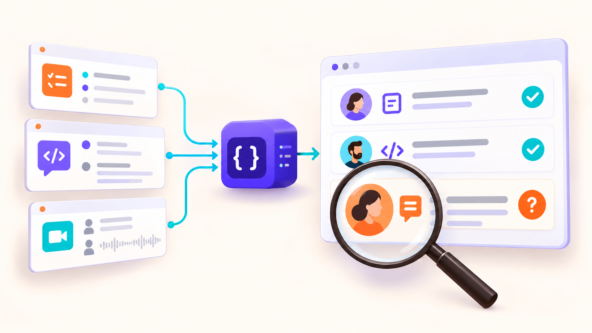
Скрипты выбирают период, за который нужно собрать события, находят автора каждого действия, считают сроки и получают обсуждения кода. Они же отмечают в комментариях фразы, которые стоит проверить: «не работает», «причина не найдена», упоминания проблем в рабочей среде и зависимостей от других изменений.
Такая отметка сама по себе еще не делает комментарий темой встречи. Она помогает модели заметить нужный фрагмент. Дальше ей остается сопоставить контекст, предложить тему и объяснить, почему ее стоит обсудить.
После доработки бриф в том же клиенте собирался с первой попытки за 6–7 минут, а контекст уменьшился примерно до 95 тысяч токенов. Ошибок в авторстве событий в этих прогонах я больше не находил. На тот же бриф у второго клиента уходило около 18 минут. Эти замеры помогали мне выбирать рабочий сценарий, но сами по себе ничего не говорили о точности выводов.
Это время генерации брифа. Чтение, проверка выводов и подготовка окончательной повестки оставались за мной. Сравнивать эти несколько минут с прежним часом всей подготовки напрямую было бы неправильно.
На живых дейликах продолжали находиться пропуски. Однажды выяснилось, что скрипт не видел запросы на изменение кода без номера задачи в названии. Среди них были срочные исправления, откаты и переключения трафика. По одному трекеру задач их было не найти, а на встречах команда о них говорила. Я доработал сбор данных, чтобы они тоже попадали в бриф.
Что пришлось учесть в работе клиентов
Часть ошибок возникала при чтении данных и обращении к рабочим сервисам.
Большие ответы пришлось сокращать до передачи модели. Один из клиентов сохранял объемный ответ сервиса в файл, а затем искал в нем нужные фрагменты по тексту. Снимок доски ретроспективы в RetroPoint размером 36 КБ он так и не дочитал до комментариев к карточкам, поэтому итоги выходили неполными. Помог скрипт, который разбирает снимок и возвращает короткую выжимку.
Инструкции потребовали более точных формулировок. Фразу «каналы чата только на чтение» агент понял как «каналы не читать». Теперь я отдельно указываю, что нужно прочитать и какие действия запрещены: «прочитай обсуждения в каналах, ничего в них не пиши».
Ответы сервисов должны соответствовать описанию инструмента. Один клиент строго сверял их с объявленной схемой. Так ломалась запись в протокол встречи в RetroPoint: сервис запрашивал подтверждение, но такой вариант ответа не был описан в схеме. Позже похожая ошибка нашлась в поиске людей через календарь. Если поиск никого не находил, сервис возвращал пустое значение вместо пустого списка. Клиент отклонял ответ, и модель получала ошибку вместо результата «никого не найдено».
Нужные сценарии я стал вызывать явно. Один клиент сам выбирал подходящие инструкции реже, чем другой. Указание имени сценария помогало начать работу с нужного набора правил.
Как отличить договоренность от выполненной работы
Следующие ошибки проявились уже на ежедневных встречах. Ассистент терял итоги прошлого дейлика и иногда превращал договоренность в свершившийся факт. Мог написать «переключили», хотя связанные изменения кода все еще ожидали принятия.
Случались и выводы по неполным данным. Если у человека не было событий в трекере и системе с кодом, в брифе появлялась отметка «активность не подтверждена». При этом сотрудник мог весь день писать план в базе знаний.
Для тимлида такие ошибки существенны. От них зависит, к какой теме нужно вернуться, кого звать на обсуждение и можно ли двигаться дальше.
Я добавил карточку прошлого дейлика: итоги, договоренности и темы, к которым команда вернулась. Перед новой встречей скрипт сверяет упомянутые задачи и изменения кода с их текущим состоянием. Если тема возникает второй дейлик подряд, бриф предлагает назначить ответственного или вынести ее в отдельное обсуждение.
Появилась и проверка брифа перед публикацией. Она ищет противоречия вроде принятого кода при все еще открытом запросе. Вместо дней недели требует конкретные даты, чтобы формулировки из старого протокола не переносились в новую повестку без привязки ко времени.
У сведений об отпуске теперь должен быть источник: план, календарь отсутствий или слова тимлида. Изменения в базе знаний тоже учитываются при сборе событий по сотруднику.
Скрипт стал замечать и другие несоответствия: наступил срок этапа, а исполнитель не назначен, задача закрыта при непринятых изменениях кода, релиз прошел в период остановки релизов.
Для дейлика в чате появился отдельный режим. Ассистент разбирает ответы по людям и темам, отмечает тех, кто не ответил, и собирает итог. Заодно помогает заметить, что человек написал «беру задачу», а в трекере исполнителем остался кто-то другой.
Отдельно пришлось проверять полноту данных. Однажды подключение к RetroPoint не запустилось, но агент продолжил работу. Из брифа выпали прошлые договоренности. По готовому тексту было непросто понять, что целый источник не удалось прочитать.
С тех пор при проверке я смотрю и на доступность источников. Отсутствие темы в брифе еще не означает, что с ней все в порядке.
Сто вызовов на протокол встречи в RetroPoint
Повестку и протокол по участникам Teamsy записывает в RetroPoint. В одной из моих встреч было 13 участников и 44 поля протокола. В них фиксировались результаты с прошлого созвона, текущая работа, препятствия и следующие шаги.
Большинство полей принадлежало другим участникам. Когда ассистент заполнял их от моего имени, запись занимала два вызова: сначала сервис запрашивал подтверждение, затем операция повторялась с ним. На один дейлик уходило около сотни вызовов.
Примерно после 30 вызовов подряд сервис отвечал, что запросов слишком много. У одного из клиентов был еще и собственный лимит на запуск. Поля приходилось дописывать партиями по семь.
Здесь понадобилась доработка RetroPoint. Я добавил пакетную запись: повестка записывается одним вызовом, поля протокола другим, с отдельным подтверждением каждого пакета. Для поля можно выбрать режим: заполнить только пустое, дописать абзац или заменить прежний текст ассистента.
Режим выбирает скрипт. Если человек заполнил поле сам, его текст сохраняется, а дополнение ассистента появляется ниже. Ранее записанный ассистентом фрагмент скрипт распознает по пометке «по данным на такую-то дату, подтвердить на встрече». При повторном запуске этот фрагмент можно обновить, не добавляя еще одну копию.
В ответах сервиса также появился остаток доступных вызовов. Это позволяет клиенту учитывать ограничение до того, как начнут приходить отказы.
Следующей задачей стали встречи один на один
У меня три команды, всего 12 человек. В начале месяца я назначал каждому встречу один на один: открывал календарь, искал свободное время, создавал приглашение. Эту рутину тоже хотелось сократить.
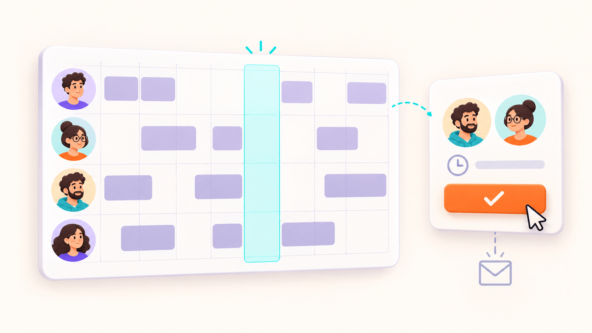
В Teamsy появились поиск общих свободных интервалов, назначение разовых и регулярных встреч и отдельный сценарий для 1:1.
Когда я обсуждал эту задачу с коллегами, выяснилось, насколько по-разному тимлиды проводят 1:1. Кто-то встречается по 30 минут раз в две недели, кто-то по часу раз в месяц. Я в начале месяца назначаю встречи сразу всем.
Поэтому предусмотрел два режима: по одной встрече с каждым в выбранном периоде или регулярная серия. При настройке Teamsy спрашивает длительность, частоту, исключения для отдельных людей и кого не нужно включать. Темы к разговору он собирает из заметок по сотруднику.
При подборе времени учитываются рабочие часы и обед, часовые пояса, отпуска, праздники и промежутки между встречами. Если рабочий день коллеги заканчивается в 16:00 по Москве, свободный интервал в 17:00 ему не подойдет.
С праздниками это стало понятно после первого прогона на живых календарях. Их список в настройках был пустым, и в плане оказалась встреча на 4 ноября. Нерабочий день не обязательно отмечен в календаре как занятый. Теперь скрипт предупреждает, если праздники не заданы.
Сначала Teamsy показывает план. Его можно поправить обычной фразой, например перенести одну встречу на четверг. Приглашения появляются в календарях только после подтверждения.
Это особенно важно из-за ограничений подключения к календарю: доступный агенту интерфейс не умеет менять и удалять встречи и не защищает от повторного создания. Если ассистент ошибется, отменять встречу придется вручную, а приглашение уже уйдет человеку. Поэтому каждую созданную встречу Teamsy сразу отмечает в файле плана и при следующем запуске пропускает.
При планировании встреч Teamsy создает запись и в RetroPoint. Календарь и RetroPoint умеют отправлять приглашения, поэтому без дополнительного правила участнику могли прийти два письма. Я оставил отправку за календарем, а в RetroPoint встреча создается без уведомления.
Как появились отдельные ссылки на созвоны
Календарь прикреплял к встрече ссылку на собственную конференцию, а команда пользовалась другим сервисом видеосвязи. Сначала я указал в настройках свою постоянную комнату, но для каждой встречи нужна была отдельная.
Я посмотрел исходники плагина, который создает созвоны в рабочем мессенджере. Оказалось, что он не обращается к API видеосервиса: генерирует имя комнаты из темы и случайных символов, затем собирает ссылку. Комната появляется при входе первого участника.
Teamsy стал делать так же и размещать ссылку первой строкой приглашения. Во время проверки обнаружилась еще одна деталь: открытая в браузере ссылка сразу запустила приложение видеосвязи и привела меня в тестовую комнату. Проверка ссылки оказалась полноценным входом в созвон. Это тоже пришлось учитывать при проверках.
Календарные данные тоже пришлось обрабатывать скриптом
В первом прогоне планирования 1:1 агент получил данные календарей и решил самостоятельно сохранить их в файл. Он переписал интервалы в собственном формате и предложил сомнительное время. По ходу работы вставлял пробел в адрес электронной почты и называл время в UTC московским.
Здесь повторилась история с дейликом. Я поручил модели перенос данных, который можно было выполнить скриптом.
Поиск людей и получение занятости я вынес в код. Скрипт сам обращается к календарю, а модель получает готовый результат. Для подбора времени используются интервалы занятости. Названия и участников чужих встреч Teamsy не сохраняет в файлах и не передает модели.
После этого в проверочных прогонах оба клиента находили одинаковые свободные интервалы. Поиск общего окна для четырех человек в одном из запусков занял 77 секунд.
В успешном прогоне план встреч один на один был готов примерно за две минуты. На первом прогоне уходило почти пять. Но стабильности еще не хватало: два из четырех запусков в одном клиенте оборвались на середине, повторные попытки проходили.
Я стал сокращать объем данных, которые агент читает по пути. В частности, запретил открывать код служебных скриптов: раньше он мог загрузить целиком файл почти на 800 строк. Длинные документы стал собирать по разделам.
Эти ограничения приходилось учитывать вместе с инструкциями для модели. Даже правильно описанный сценарий не помогал, если выполнение обрывалось до результата.
Что изменилось для меня и команды
На этапе проверки я запускал подготовку дейлика в двух клиентах параллельно. Сравнивал брифы, читал исходные обсуждения и затем публиковал повестку. Каждую доработку проверял на данных своей команды. Так находились пропуски, которые были заметны на реальной встрече.
Ошибки в оценке оставались. Например, агент мог принять черновые изменения самого разработчика за зависимость от другой команды. Скрипт способен показать автора и статус, но вывод о том, кто кого ждет, все равно требует понимания ситуации.
Тем не менее характер подготовки изменился. Мне стало реже нужно вручную сводить события из нескольких систем. Я получил собранный материал, с которым можно работать: проверить спорный вывод, убрать лишнюю тему, вернуться к незавершенной договоренности.
Неожиданным для меня оказался отзыв команды: коллегам была полезна сама ежедневная повестка в RetroPoint со сводкой по каждому участнику. По их словам, стало проще понимать, кто на каком этапе и что уже закончил, и планировать собственную работу с агентами. Многие уточнения, за которыми раньше приходилось идти друг к другу, теперь снимались этой сводкой.
Для себя я разделил эту работу на три части. Скрипты собирают факты и выполняют проверки по правилам. Модель связывает информацию и предлагает темы. Я оцениваю выводы и подтверждаю действия, которые затрагивают других людей.
Отдельно я ограничил доступ к личным заметкам тимлида. Они хранятся в закрытой папке, которая не попадает в репозиторий. Сценарии, публикующие что-либо для команды, ее не читают. Оценки сотрудников не должны случайно оказаться в общем брифе, повестке или письме.
Что дальше
Дальше я планирую добавить поддержку внутреннего плагина для Obsidian, приложения для заметок. Это плагин компании, где я работаю. В нем можно вести повестку 1:1: темы к следующей встрече, договоренности с ответственным и сроком, итоги разговора.
Я уже разобрал, как этот плагин хранит данные. После интеграции заметки можно будет вести через него, в обычных файлах или в RetroPoint. Команды для тимлида останутся прежними, изменится место хранения.
Пока главная польза для меня проявляется утром перед дейликом. Я прихожу с подготовленными вопросами и могу потратить время встречи на разговор с командой: что действительно мешает работе и какую помощь нужно организовать. История задач дает основу для этого разговора, но всех ответов в ней нет.
А как вы используете агентов в своих повседневных задачах?
Источник: vc.ru
Оцените материал: