Передача текста замедляет работу моделей ИИ. Технология C2C позволяет им обмениваться данными через кэш ключ-значение.
Бен Диксон
Когда в многоуровневой системе LLM работа передается от одной модели к другой посредством текста — будь то маршрутизатор, переключающийся между моделями, или агенты, совместно работающие над задачей, — первая модель должна сжать свои знания в текст, а следующая должна прочитать этот текст и восстановить содержащуюся в нем информацию. Такая передача может привести к потере информации и увеличению времени вывода.
Технология Cache-to-Cache (C2C), предложенная исследователями из Университета Цинхуа и других китайских учреждений, пытается решить эту проблему, позволяя моделям обмениваться информацией через внутренние представления, хранящиеся в их кэшах типа «ключ-значение» (KV), вместо того, чтобы полагаться только на промежуточный текст.
В экспериментах исследователей C2C повысил точность примерно на 3,1–5,4 процентных пункта по сравнению с текстовой связью и уменьшил задержку между протестированными парами моделей. Для корпоративных команд, разрабатывающих маршрутизаторы моделей или многоагентные системы, результаты показывают, что сам коммуникационный слой может стать объектом оптимизации.
C2C также вписывается в более широкое направление исследований в области многомодельного ИИ, направленное на то, чтобы позволить моделям обмениваться внутренними представлениями напрямую, а не принудительно передавать каждую операцию через текстовые токены. Работа была опубликована на ICLR 2026, и в сентябре исследователи заявили, что планируют выпустить реализацию «управляемого агентом KV-Cache» вместе с системой обслуживания.
Текст является дорогостоящим узким местом между моделями.
Многоуровневые LLM-системы бывают разных конфигураций. В системах для совместной работы модели берут на себя разные роли и обмениваются анализом, инструкциями или частичными решениями. В системах маршрутизации оркестратор переключается между моделями с различными возможностями и стоимостью по мере развития диалога или рабочего процесса.
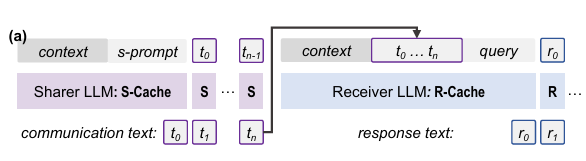
Эти системы обычно используют текстовые токены для передачи информации между моделями. Исследователи утверждают, что это создает три проблемы.
Первая проблема — потеря информации. Модель внутренне представляет контекст в виде многомерных числовых состояний. Для передачи информации посредством текста ей необходимо сжать часть этого представления в последовательность текстовых токенов. Затем принимающая модель должна интерпретировать эту последовательность и построить собственное представление того, что имела в виду первая модель, возможно, теряя при этом информацию.
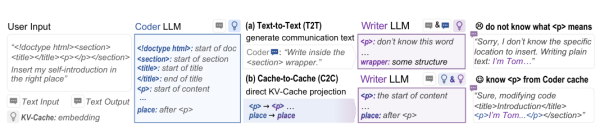
Ещё одна проблема заключается в том, что текстовая информация может быть неоднозначной. Исследователи иллюстрируют это на примере модели «Кодер и писатель», изменяющей HTML-документ. Кодер понимает, что
обозначает определённое структурное место в документе, но его текстовая инструкция не передаёт эту информацию достаточно точно. Писатель не может разместить запрошенный контент в нужном месте.
Наконец, текстовая коммуникация накладывает значительные издержки на вывод информации в системе ИИ. Первая модель должна генерировать сообщение последовательно, токен за токеном. Затем эти токены добавляются к входным данным второй модели, которая должна обработать более длинный контекст, прежде чем сможет сгенерировать ответ. Чем длиннее передача данных, тем больше работы приходится выполнять обеим моделям. В системах с длинным контекстом или многократными передачами данных между агентами эти накладные расходы на коммуникацию могут быстро накапливаться.
Превратите кэш ключ-значение в коммуникационный уровень.
C2C пытается избежать дополнительной генерации текста и обработки передачи данных приемником, используя для обмена данными уже созданное моделями представление: кэш ключ-значение.
Когда модель LLM впервые обрабатывает запрос, она выполняет этап «предварительного заполнения», который преобразует входные данные во внутренние представления ключа и значения. Эти представления сохраняются в кэше ключ-значение и используются повторно при генерации ответа моделью. Эти кэшированные состояния ключа и значения кодируют информацию, которую модель получила из контекста.
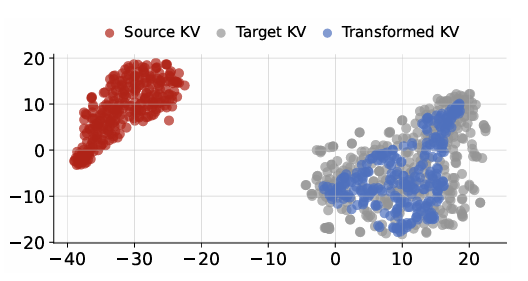
Сначала исследователи проверили, может ли кэш ключ-значение служить средством связи. Их эксперименты показали, что информацию, хранящуюся в кэше ключ-значение, можно пополнять, не увеличивая его длину, и что кэш, созданный одной моделью, может быть преобразован в пространство представлений другой модели.
C2C основывается на этих результатах. Обе модели обрабатывают один и тот же контекст. Одна выступает в роли «поставщика», а другая — в роли «получателя». Обученный механизм объединения кэша отображает кэш Поставщика в пространство представлений Получателя, а затем объединяет его с собственным кэшем Получателя. Обученный вентиль управляет тем, какие слои Получателя должны получать дополнительную информацию.
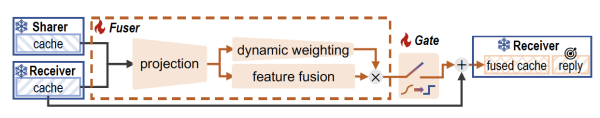
В системах маршрутизации это позволяет получателю использовать информацию из кэша отправителя без необходимости промежуточного текстового сообщения. Обе модели по-прежнему обрабатывают общий контекст для создания собственных кэшей ключ-значение. В системах совместной работы это создает еще один канал связи наряду с текстом.
C2C в действии
Исследователи протестировали C2C на тестах логического мышления и обработки знаний, включая MMLU-Redux, OpenBookQA, ARC-Challenge и C-Eval. При использовании Qwen3-0.6B в качестве приемника и трех разных участников обмена данными, C2C повысил среднюю точность приемника примерно на 9,6–11,9 процентных пунктов по сравнению с работой приемника в одиночку, превзойдя скорость обмена текстом примерно на 3,1–5,4 пункта. Это результаты бенчмарков, а не тестов рабочих нагрузок производственных агентов. Измерения задержки проводились с размером пакета 1 на одном видеокарте Nvidia A100.
Улучшение задержки существенно различалось в зависимости от пары моделей. C2C оказался в 3,46, 1,51 и 14,41 раза быстрее, чем текстовая связь, для трех основных конфигураций Sharer. Результат в 14,41 раза был получен с базовой моделью Qwen3-4B в качестве Sharer; исследователи отмечают, что модель иногда игнорировала инструкции текстовой связи и генерировала сообщения большей длины, чем ожидалось, что делало базовый уровень текстовой связи особенно медленным.
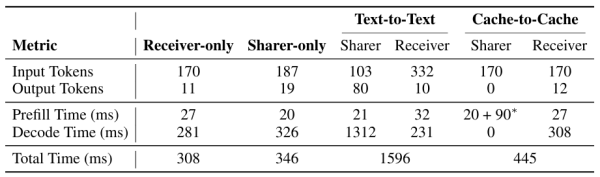
В одном эксперименте с текстовой связью отправитель генерировал в среднем 80 коммуникационных токенов. Генерация этих токенов занимала 1312 миллисекунд. Полученное сообщение также увеличивало количество токенов, которые получателю приходилось обрабатывать. В отличие от этого, связь «от отправителя к получателю» требовала всего около 90 миллисекунд на объединение кэша и не нуждалась в генерации текстовых токенов.
Этот метод также работал, когда две модели имели разную архитектуру или специализацию. Тесты включали комбинации Gemma-to-Qwen, Qwen Math-to-Qwen и Qwen Coder-to-Qwen. C2C превзошёл текстовую коммуникацию во всех пяти гетерогенных и переставленных конфигурациях моделей, описанных в эксперименте.
Что необходимо для развертывания C2C
Для C2C не требуется тонкая настройка участвующих LLM. Исследователи замораживают Sharer и Receiver и обучают только модуль слияния кэша, используя стандартную целевую функцию прогнозирования следующего токена.
Однако для обеспечения межмодельной коммуникации требуется инженерная работа. Разные модели могут иметь разные токенизаторы, количество слоев и размеры представления. C2C выравнивает токены, сгенерированные разными токенизаторами, и сопоставляет соответствующие слои трансформеров перед объединением их кэшей. Обучение моста также требует первоначальных затрат. Команда опубликовала код и конфигурации C2C на GitHub под лицензией Apache 2.0, а также предварительно обученные контрольные точки объединения C2C на Hugging Face.
Один нюанс заключается в том, что, поскольку C2C необходимо считывать, преобразовывать и заменять внутренние состояния KV-кэша, для его работы требуется стек вывода, который предоставляет доступ к этим внутренним механизмам. Это делает его актуальным сегодня в первую очередь для команд, которые контролируют свой собственный стек вывода, а не для приложений, объединяющих модели исключительно через закрытые API.
Студентам магистратуры, возможно, не понадобятся токены для общения друг с другом.
C2C вписывается в более широкое направление исследований, в котором ставится вопрос о том, должен ли текст оставаться интерфейсом по умолчанию в многомодельных системах искусственного интеллекта.
В качестве примера можно привести исследования Nvidia по передаче KV-кэша между моделями. Когда система переключается между моделями во время длительной сессии, новой модели обычно приходится обрабатывать накопленный контекст и заново создавать свой кэш. Вместо этого Nvidia отображает существующий кэш в формат целевой модели. Исследователи Nvidia сообщили, что на совместимых парах моделей этот метод работал в 2,7–25 раз быстрее, чем повторное заполнение.
В то время как технология Nvidia передает весь кэш ключ-значение между исходной и целевой моделями, технология C2C позволяет обеим моделям обрабатывать контекст, а затем объединять их кэши, чтобы приемник мог воспользоваться семантическим представлением другой модели.
Еще один пример в этой области — RecursiveMAS, многоагентная платформа, которая заменяет текстовые сообщения непрерывными скрытыми представлениями, передаваемыми между агентами. Эксперименты показали ускорение вывода до 2,4 раз и сокращение использования токенов на 75,6% по сравнению с ее текстовым рекурсивным аналогом.
Механизмы различаются, но их объединяет одна и та же основная идея: модели могут обмениваться информацией более эффективно, если им не нужно сначала переводить все данные в текстовый формат.
На данный момент C2C — это результат исследований, а не производственная архитектура: для его работы требуется доступ к внутренним механизмам модели, а его преимущества были измерены на основе бенчмарков, а не реальных рабочих нагрузок корпоративных агентов.
Источник: venturebeat.com
Оцените материал: