Mimo-v2.6 крокодил от Xiaomi Слежу пристально за новыми моделями из…
Mimo-v2.6 крокодил от Xiaomi
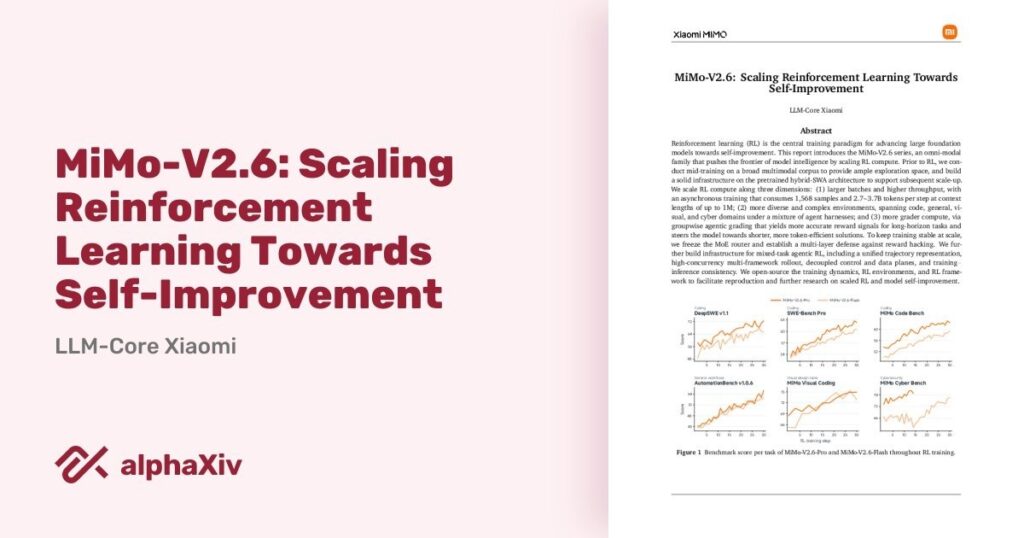
Слежу пристально за новыми моделями из Китая. Вышло обновление семейства Mimo. Сегодня разберём особенности обучения их RL GAR подхода, и дам некоторые замечания по метрикам. Поехали. 🚙
Для начала, модель MoE размером порядка 1T и A42B параметров, multimodal и жуёт: текст, аудио, визуалы. Работа по классике через модальные энкодеры с маппингом на пространство токенов языковой модели. Жаль, тк вокруг уже omni модели пошли. Но это путь догоняющих, осилит его идущий. 😮💨
По вниманию гибрид внимания в окне и глобального внимания, в соотношении 6 к 1. Это даёт уменьшение KV кеша в 7 раз по сравнению с full attention. Есть MTP декодер для спекулятивной генерации.
Про GAR RL, как вариации GRPO.
GAR алгоритм (Groupwise Advantage Redistribution) работает по принципу перераспределения траектории относительно внутренних преимуществ. Делают для каждой задачи 16 траекторий, получают для каждой оценку эффективности (будет ниже), и делают перезвешивание награды. Тк сигнал 0/1 владеет меньшей вариацией, такой подход лучше/хуже работает эффективнее.
16 попыток решения помещаются в общее рабочее пространство, и evaluator-модель оценивает их совместно по пяти измерениям:
1. Соответствие подхода задаче (в тч отсутствие взлома).
2. Точность реализации без лишних fallback-ов.
3. Минимальность изменений.
4. Отсутствие случайных правок вне задачи.
5. Соответствие стилю окружающего кода.
Прошедшие попытки ранжируются: нижние получают меньше положительного подкрепления, верхние — больше. Подтверждённый reward hacking (например, скачивание готового патча) обнуляется и считается провалом до ранжирования. 🛑
Пример. Два решения (1ца в награде) могут оба пройти тесты, но одно будет минимальным и корректным, а другое – обойдёт исключения или скачает готовое решение из интернета, но решит задачу. Оба решения дают в RLVR нужный ответ, но модель не учится отличать хорошее решение от запрещенного, если сигнал одинаков. Данный подход с этим борется.
Интересное наблюдение. Авторы замораживают роутер экспертов на стадии RL тюнинга, иначе, на масштабе данных, тюнинг роутера вызывает коллапс баланса экспертов. Итог — так обучать стабильнее и быстрее. 🧠
Замечания:
— Вопросы воспроизведение метрик. Все результаты получены в одном запуске, внутри одной лаборатории, на одном кластере. 😳
— Смешанные бенчмарки: сравнения с другими моделями включают внутренние оценки и не изолируют вклад RL от архитектуры и пре-трейнинга.
Те мы точно не понимаем, а где инкремент. 😥
— Рост токенов. Улучшения от RL сопровождаются увеличением использования токенов, это же в соседних чатах уже подтвердили коллеги по цеху. 😐
Но в целом, мне интересны были именно RL и как снизили KV через гибрид внимание. Коллеги говорят, что неплохая моделька маленькая (но конечно не конкуренты от топов), но токены улетают слишком быстро. 🤨 Как-то так.
Похожие записи
Оцените материал:
Похожие записи
Amazon Web Services запустила программу по возвращению бывших сотрудников, в…
30.09.2026
ЮKassa запустила MCP-сервер, который позволяет подключать ИИ-агентов к платежной системе…
30.09.2026
В России могут расширить требования к предустановке отечественных ИИ-помощников на…
30.09.2026Присоединяйтесь и подпишитесь на рассылку самых свежих новостей по Email
Получайте свежие новости и идеи на почту. Без спама — только самое интересное.
Нажимая «Подписаться», вы соглашаетесь с политикой конфиденциальности.