Автоматизация создания связных видеороликов большого формата
Мы представляем единую многоагентную структуру, которая автономно генерирует согласованные во времени длинные видеоповествования, преодолевая проблему смещения идентичности и каскадных сбоев, характерных для существующих линейных конвейеров искусственного интеллекта.
Быстрые ссылки
- Сорежиссер видео с использованием ИИ
- ХОЛСТ
- А²РД
- VQQA
- Делиться
Последние достижения в области распространения видео демонстрируют замечательное качество генерации с помощью моделей, способных отображать реалистичные сцены за считанные секунды. Однако, хотя модели распространения создают высококачественные видеоклипы, преобразование их в связные длинные повествования остается сложной задачей.
Большинство существующих конвейеров обработки данных автоматизируют этот процесс с помощью связанных модулей, но страдают от семантического дрейфа (незначительные изменения в одежде персонажей или декорациях между кадрами) и каскадных сбоев (например, артефакт исходного ресурса, искажающий синтез видео на последующем этапе) из-за независимых, созданных вручную подсказок. Поскольку ранние ошибки распространяются и нарушают долгосрочную согласованность, процесс часто требует исчерпывающего ручного вмешательства. С точки зрения структуры, это отражает классическую проблему распределения заслуг, поскольку конечные сбои трудно отследить до конкретных подсказок. Кроме того, существующие методы страдают от дрейфа функций , когда сущности и окружение постепенно изменяются непреднамеренно, или от коллапса контента , когда повествование не развивается осмысленно.
Сегодня мы представляем наше исследование по созданию видеорежиссёра на основе ИИ — унифицированной многоагентной структуры, которая явно планирует визуальную непрерывность в многокадровых повествованиях. Эта структура, построенная как слой оркестровки поверх Gemini и Veo, изначально наследует механизмы безопасности, такие как водяные знаки SynthID. Рассматривая создание длинных видеороликов как задачу глобальной оптимизации и отслеживания состояния мира, мы разработали набор структур — Co-Director (будет представлен на COLM 2026), CANVAS (будет представлен на EMNLP 2026), A²RD и VQQA — которые преобразуют высокоуровневые творческие спецификации человека в исполнение, автоматизируя повторяющиеся задачи оркестровки, от подсказок для нескольких моделей и цепочки кадров до замкнутого цикла визуального уточнения.
Мы разработали эти фреймворки как отзывчивых партнеров по творчеству, которые снимают с пользователей бремя поддержания визуальной целостности, освобождая их от необходимости концентрироваться на искусстве повествования. Эта архитектура отделяет творческий синтез от согласованности, моделируя качество как цель, оцениваемую в процессе тестирования. В ходе всесторонних оценок наш фреймворк демонстрирует существенное улучшение согласованности многокадрового повествования и сохранения персонажей, успешно генерируя видеоролики длительностью в несколько минут, одновременно снижая визуальный дрейф и распространение ошибок в конвейере обработки данных.
Как это работает
Для решения многогранной проблемы обработки видеоданных за длительный период мы разделили исследование на четыре основных направления, каждое из которых направлено на устранение конкретного узкого места в генеративном конвейере.
1. Координирование творческого замысла с помощью видеорежиссера, использующего искусственный интеллект.
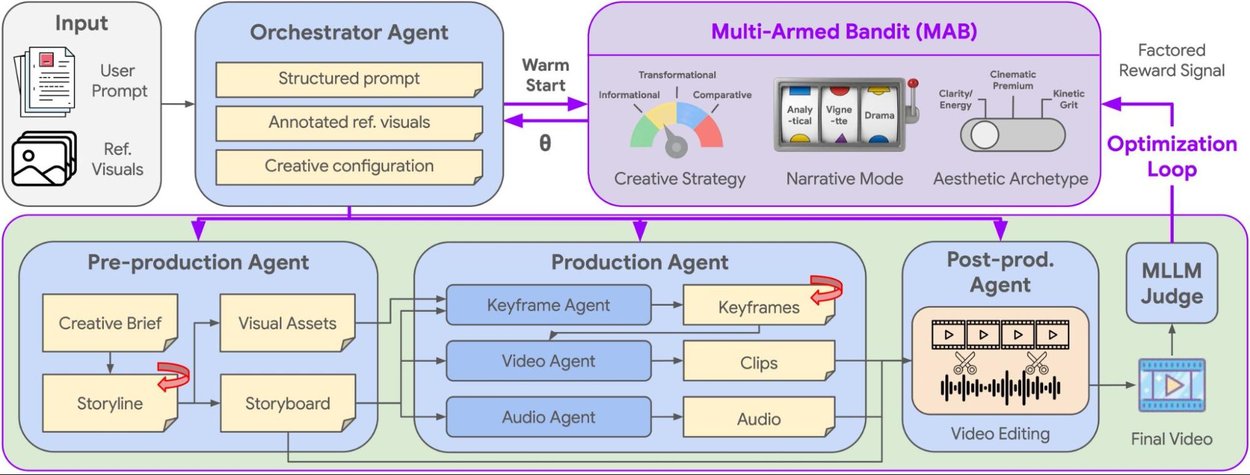
Для обеспечения семантической согласованности всего видеоряда мы представляем AI Video Co-Director — иерархическую многоагентную структуру, формализующую повествование в видео как задачу глобальной оптимизации. Вместо жестких линейных цепочек подсказок мы вводим иерархическую параметризацию: многорукий бандит (MAB) глобально определяет перспективные творческие направления.
Это формализует творческий процесс как поиск оптимального баланса между исследованием новых нарративных стратегий и использованием эффективных творческих конфигураций. Система отбирает абстрактные творческие траектории — такие как сочетание информационной стратегии с нарративным режимом виньетки и определенным эстетическим архетипом — и динамически внедряет их в подсказки системы суб-агентов. Такое нисходящее управление гарантирует, что весь конвейер работает в рамках единого видения. Поскольку наша структура сорежиссера видео на основе ИИ работает как уровень оркестровки, она достигает этого видения, передавая эти структурированные подсказки непосредственно в базовые модели Gemini и Veo (хотя ее архитектура, не зависящая от модели, позволяет ей работать поверх любой базовой генеративной модели). Эта архитектура гарантирует, что все сгенерированные изображения, видео и аудио изначально несут в себе встроенные средства защиты, включая водяные знаки SynthID. Для производства к конечному видео могут быть применены дополнительные классификаторы безопасности для защиты от непреднамеренных контекстных взаимодействий между отдельными безопасными клипами.
Конвейер обработки данных осуществляет глобальную оптимизацию посредством двух взаимосвязанных циклов: стратегического управления и многоэтапного производства. Сначала агент-оркестратор оценивает входные данные с помощью алгоритма MAB для выбора творческой конфигурации по трем параметрам: (1) Творческая стратегия (намерение), (2) Режим повествования (структура сюжета) и (3) Эстетический архетип (визуальный тон и кинематография). Эта конфигурация определяет иерархию производства. Агент предварительной подготовки синтезирует краткий покадровый сюжет и визуальные элементы в единую раскадровку. Затем агент производства преобразует эту раскадровку в конкретные аудиовизуальные материалы с помощью специализированных субагентов: агент ключевых кадров закрепляет визуальные элементы персонажей и сцен, агент видео добавляет движение, а агент аудио добавляет соответствующий закадровый голос и музыку.
Наконец, многомодальный судья LLM (MLLM) анализирует составленный вариант по трем заданным параметрам, передавая факторизованный сигнал вознаграждения обратно в MAB для итеративного уточнения и оптимизации выбора в последовательных циклах генерации.
Конвейер многоагентного управления видео с использованием ИИ. Вверху: Агент-оркестратор использует MAB для навигации в пространстве факторов, определяющих творческие действия. Внизу: Агент предварительной подготовки синтезирует креативный бриф, сюжетную линию и визуальные элементы для создания согласованной раскадровки, которую Агент производства преобразует в синхронизированные ключевые кадры, видеоклипы и аудио. Судья MLLM оценивает финальное видео, чтобы сгенерировать сигнал вознаграждения, который передается обратно в MAB для итеративного уточнения творческой конфигурации в циклах оптимизации.
2. Визуальная раскадровка с помощью CANVAS
Даже при наличии единого сценария создание длинных последовательных кадров часто приводит к смещению персонажей и нестабильности окружения. Для решения этой проблемы мы представляем Continuity-Aware Narratives via Visual Agentic Storyboarding (CANVAS) — многоагентную структуру, которая явно планирует визуальную непрерывность в многокадровых повествованиях.
CANVAS обеспечивает согласованность, поддерживая структурированные представления персонажей, локаций и состояний объектов по мере развития сюжета. Созданный как слой оркестровки поверх Gemini, он опирается на постоянную визуальную память. Извлекая визуальные якоря из памяти или инициализируя новые по мере необходимости, CANVAS обеспечивает плавные переходы в рамках одной и той же локации. Такое явное моделирование состояния мира гарантирует, что персонажи сохраняют свою индивидуальность, а окружение — свою пространственную структуру при повторном посещении.
Чтобы увидеть это в действии, на рисунке ниже показана последовательность ограбления музея, снятая несколькими кадрами, с сравнением CANVAS с репрезентативными базовыми моделями: прямой генерацией с использованием базовой модели (Gemini-3.1-Pro) и альтернативной многоагентной структурой (AutoStudio). Подсказки внизу рисунка выделяют повторяющиеся элементы — например, вор, выставочный зал и драгоценный камень — которые должны сохранять идентичные визуальные характеристики. Обратите внимание, как каждый метод обрабатывает последовательные переходы (например, одежда персонажа) по сравнению с непоследовательными переходами (например, когда камера возвращается в главный зал после обхода). Генерация только с помощью Gemini-3.1-Pro демонстрирует несоответствие реквизита (артефакт меняется) и смещение фона (планировка помещения меняется), показывая ограничения неконтролируемой генерации. AutoStudio также ухудшает качество изображения при переходах между кадрами, что приводит к смещению персонажа (кепка вора исчезает) и несоответствию фона. В отличие от этого, устойчивая визуальная память CANVAS гарантирует, что персонажи, пространственная геометрия и состояния объектов остаются идеально согласованными на протяжении всего повествования.
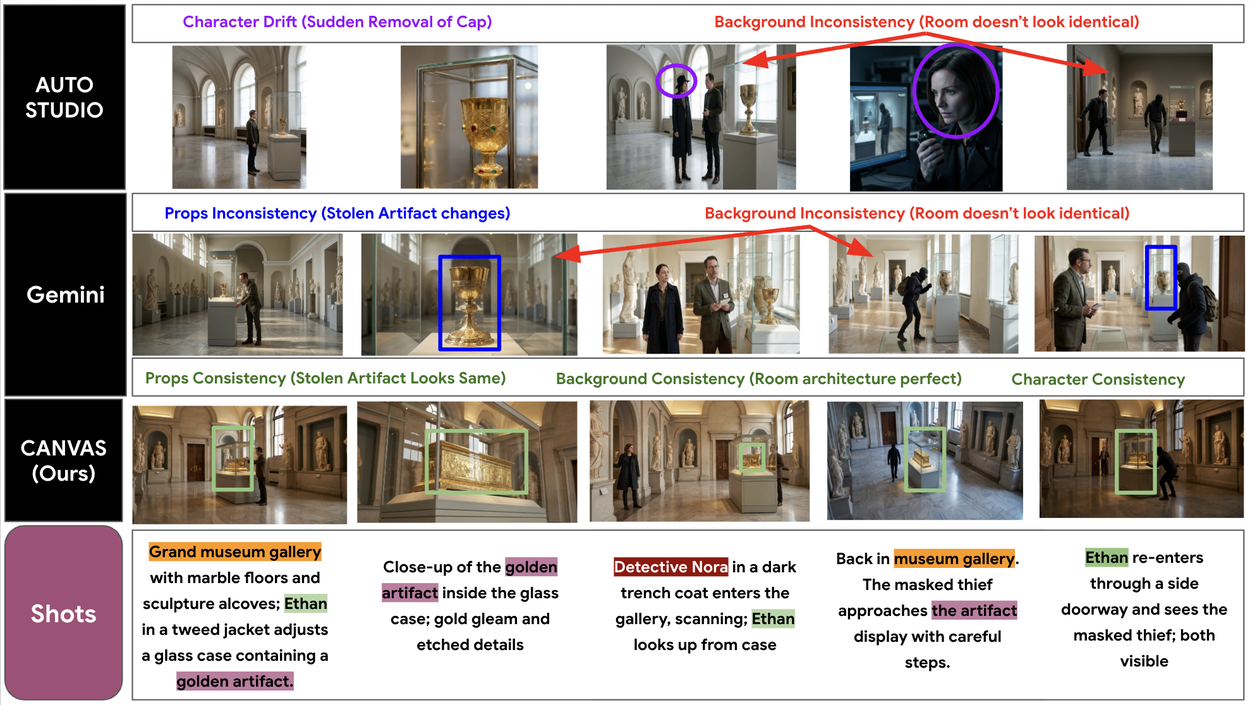
Визуальное сравнение раскадровок сцены ограбления музея из HardContinuityBench, сопоставляющее CANVAS с базовыми версиями AutoStudio и Gemini-3.1-Pro.
3. Масштабирование временной динамики с помощью A²RD
Для преобразования раскадровок в видеоролики длительностью в несколько минут мы разработали A²RD — агентную авторегрессивную архитектуру для генерации видео. A²RD обеспечивает сегментную генерацию, дополненную многомодальной видеопамятью, которая отслеживает контекст и динамику сегментов.
Для каждого сегмента используется цикл «получение-синтез-уточнение-обновление». Ключевой частью этого цикла является адаптивное определение агентом режима генерации сегментов. Он плавно переключается между экстраполяцией — для обеспечения естественного развития сюжета — и интерполяцией, которая привязывает сегменты к существующим объектам и окружению. Это эффективно уравновешивает необходимость продвижения сюжета с необходимостью сохранения физической реальности сцены.
Для проверки этой системы в представленном ниже десятиминутном видеоролике демонстрируется генерация длинного видеоряда, требующая последовательного развития сюжета на протяжении нескольких минут. Видео показывает, как система динамически переключается между двумя режимами работы: экстраполяция для развития сюжета в новых сюжетных поворотах и интерполяция для привязки возвращающихся персонажей и окружения к их первоначальному дизайну. В то время как стандартные видеогенераторы страдают от сильного визуального искажения — когда персонажи мутируют, а локации трансформируются — A²RD постоянно запрашивает свою многомодальную видеопамять для поддержания идентичности персонажей, деталей костюмов и структурной геометрии от начального кадра до финального.
Посмотрите фильм
Ссылка на видео на YouTube
Длинный видеоролик, демонстрирующий способность A²RD поддерживать строгую визуальную согласованность и развитие сюжета на протяжении десяти минут.
4. Уточнение с обратной связью с использованием VQQA
Наконец, нам нужен был способ, позволяющий системе автономно выявлять и исправлять визуальные артефакты. Существующие методы оптимизации во время тестирования, как правило, либо требуют больших вычислительных затрат, либо требуют доступа к внутренним механизмам модели. Для решения этой проблемы мы разработали систему ответов на вопросы о качестве видео (Video Quality Question Answering, VQQA) — унифицированную многоагентную структуру, применимую к различным типам входных данных и задачам генерации видео.
VQQA динамически генерирует визуальные вопросы, адаптированные к конкретной задаче, и использует полученные в результате оценки модели «зрение-язык» (VLM) в качестве семантических градиентов (обеспечивает направленную обратную связь на естественном языке для управления итеративным уточнением, аналогично числовым градиентам в обратном распространении ошибки). Это заменяет традиционные пассивные метрики оценки на понятную человеку, действенную обратную связь. Затем система может выполнить высокоэффективный итеративный цикл обратной связи (где модель генерирует видео, оценивает его с помощью визуальных вопросов и уточняет текстовую задачу на основе критики) через интерфейс на естественном языке. Чтобы предотвратить семантический дрейф во время этого уточнения, VQQA использует механизм глобального выбора: вместо того, чтобы слепо брать результат последней итерации, глобальный оценщик VLM оценивает каждое видео, сгенерированное на протяжении траектории оптимизации, по сравнению с исходной, неотредактированной задачей. Затем система выбирает кандидата с наивысшим баллом, гарантируя, что локальные исправления не скомпрометируют более широкий контекст.
На практике VQQA работает скорее как оптимизатор подсказок типа «черный ящик», чем как редактор на уровне пикселей. Вместо прямого изменения пикселей, он итеративно уточняет текстовую подсказку, исправляя высокоуровневые композиционные дефекты, такие как ошибки привязки атрибутов или несогласованные атрибуты символов. Эта обновленная подсказка направляет генератор к выборке нового пути в его латентном пространстве. В приведенных ниже примерах VQQA не маскирует и не закрашивает исходные кадры; вместо этого он решает проблему привязки материала модели, отображая реалистичную текстуру майларового воздушного шара на строгой кубовидной геометрии, и исправляет хаотичную смену инструментов в середине исполнения, сохраняя скрипача и пианиста неизменно привязанными к своим инструментам на протяжении всех монтажных склеек.
воспроизведение видео без звука зацикливание пауза видео без звука зацикливание включение звука видео выключение звука
Устранение ошибок привязки атрибутов. Подсказка: «Кубоидный воздушный шар проплывает мимо круглого окна, солнечный свет проникает сквозь стеклянные панели». В то время как стандартная генерация ( слева ) не может воспроизвести свойства воздушного шара, отображая жесткий куб без текстуры, VQQA ( справа ) успешно обеспечивает желаемую кубовидную форму, сохраняя при этом текстурные и материальные свойства надутого воздушного шара. Используя итеративную визуальную обратную связь, оптимизированная подсказка направляет генератор к отображению четкого, коробчатого майларового воздушного шара с определенными краями и швами, плавно проплывающего мимо освещенного солнцем окна.
Устранение временной несогласованности. Задание: «Скрипачка и пианист очаровывают гармоничным дуэтным исполнением». В варианте «ванильное поколение» ( слева ) наблюдается серьезный разрыв в непрерывности между кадрами: сначала показана пианистка и скрипач, но после монтажной склейки внезапно появляется женщина, играющая на скрипке. В варианте «VQQA» ( справа ) сохраняется строгая семантическая согласованность на протяжении всего исполнения, пианистка и скрипач постоянно привязаны к своим инструментам.
Ключевые результаты и контрольные показатели
Для тщательной оценки наших методик мы разработали три специализированных критерия, призванных отразить сложности профессионального видеопроизводства.
- GenAD-Bench : Использует конвейер обработки данных с участием человека, который сочетает Gemini 3 Pro со специализированными моделями изображений для создания 50 вымышленных брендов, каждый из которых содержит четыре различных продукта. В 400 уникальных сценариях он тестирует точные маркетинговые ограничения, не полагаясь на конфликты авторских прав или предварительные данные обучения.
- HardContinuityBench : разработан для оценки пространственной и экологической непрерывности. Созданный с использованием сложных многокадровых раскадровок GPT-5.2, этот тест проверяет модели на наличие больших промежутков между повторными появлениями в сцене, частых смен костюмов и аксессуаров у актеров, а также сложных изменений состояния интерактивных объектов.
- LVBench-C : Анализирует динамику временных изменений в долгосрочной перспективе. Этот набор данных содержит 120 текстовых сценариев, сгруппированных по изменяющимся состояниям персонажей, свойствам объектов и постепенному раскрытию окружающей среды, с соблюдением строгого правила разрыва, согласно которому критически важные визуальные элементы должны исчезнуть как минимум на 10 сегментов, прежде чем вернуться с реалистичными, сюжетно обусловленными изменениями.
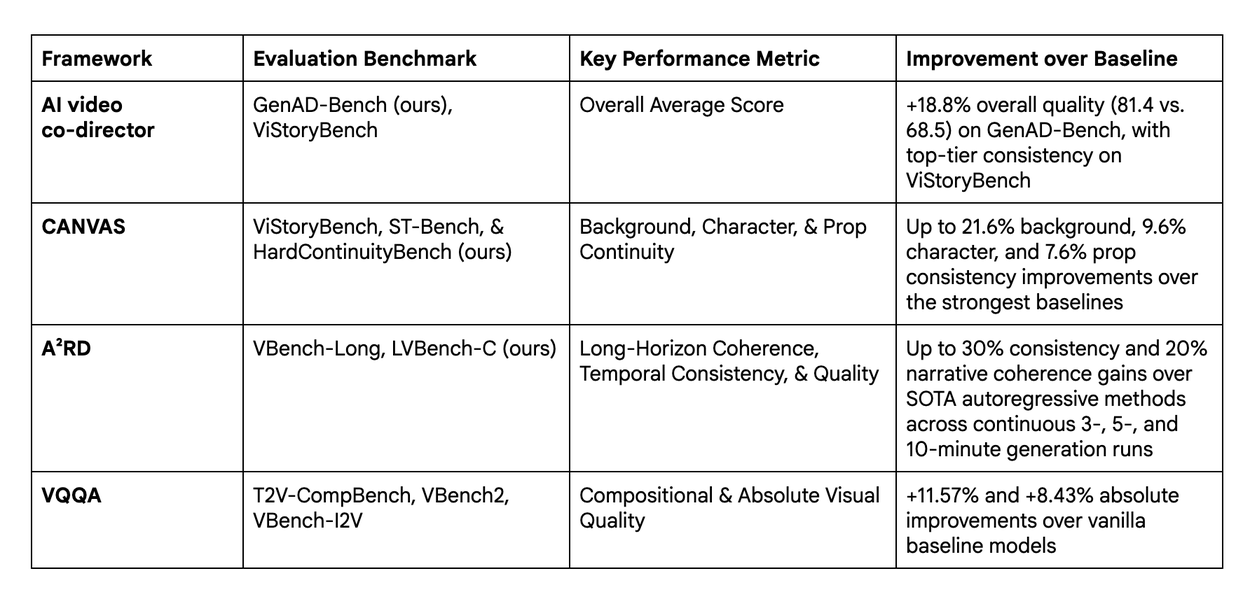
Наши оценки демонстрируют измеримое улучшение производительности по сравнению с существующими архитектурами генерации видео. Благодаря навигации в пространстве поиска креативной стратегии, AI Video Co-Director достигает пикового показателя качества 81,4 на GenAD-Bench и улучшенной согласованности сюжета на ViStoryBench. CANVAS использует структурированную визуальную память для уменьшения смещения сцен, обеспечивая значительное улучшение непрерывности при повторном появлении сцен на ST-Bench и HardContinuityBench. Для длительных временных динамических процессов A²RD минимизирует смещение компоновки, улучшая согласованность персонажей и окружения в течение непрерывных многоминутных запусков на VBench-Long и LVBench-C. Наконец, оптимизация подсказок с замкнутым циклом VQQA устраняет физические и композиционные несоответствия, обеспечивая заметное абсолютное улучшение качества на T2V-CompBench, VBench2 и VBench-I2V. Для получения подробной информации об архитектуре наших моделей, конфигурациях обучения и базовых оценках, пожалуйста, обратитесь к отдельным статьям.
Перспективы на будущее
Эти фреймворки представляют собой фундаментальный шаг на пути к раскрытию потенциала создателей в области целостного визуального повествования с долгосрочным горизонтом. По мере совершенствования этих агентных архитектур мы изучаем возможности интеграции рабочих процессов с участием человека. Наша конечная цель — не заменить человеческое повествование, а расширить возможности создателей, абстрагируясь от утомительных сложностей временной согласованности и отслеживания состояния мира, гарантируя, что они сохранят контроль над творческим направлением и нарративным дизайном.
Благодарности
Эта работа стала возможной благодаря самоотверженным усилиям наших исследовательских групп в Google. Мы хотели бы поблагодарить Эндрю Пана, Бретта Слаткина, Бурака Гёктюрка, Карину Клаассен, Даниэля Власика, До Сюань Лонга, Ишани Мондал, Жасмин Леон, Цзинъюнь Лю, Джо Тиммонса, Джордана Бойд-Грейбера, Кхана Г. Левиета, Куанга Су, Лонга Т. Ле, Михира Пармара, Мин-Йен Кана, Натана Ходсона, Ника Лозье, Палаша Гояла, Риарда Чжу, Себастьяна Ко, Скотта Пенберти, Яна Сюй, Ян Ли, Е Цзинь, Зака Чомина и Томаса Пфистера за их неоценимый вклад в эту серию исследований.
Источник: research.google
Оцените материал: