Как ошибка положила миллионы сайтов? Сбой Cloudflare
Как ошибка положила миллионы сайтов? Сбой Cloudflare
2 июля 2019 года пользователи по всему миру начали получать ошибку 502 Bad Gateway вместо сайтов. Проблема была не у конкретного хостинга и не у интернет-провайдера. Перестала работать Cloudflare.
Сначала инженеры заподозрили масштабную атаку. Картина действительно выглядела тревожно: процессоры серверов почти одновременно загрузились на 100%, а объём обслуживаемого трафика в худший момент упал на 82%.
Но никакой атаки не было. Причиной оказалась одна регулярка в новом правиле веб-файрвола.
Что пытались исправить?
Cloudflare постоянно обновляет правила своего WAF — системы, которая анализирует HTTP-запросы и блокирует попытки взлома. В тот день команда добавила правило для поиска подозрительного JavaScript, связанного с XSS-атаками.
Правило запускали в режиме симуляции. Оно должно было только отмечать опасные запросы в логах, ничего не блокируя. На первый взгляд безопасный вариант: сначала посмотреть, как фильтр поведёт себя на реальном трафике, и лишь потом включить защиту.
Только режим симуляции не отменяет вычисления. Чтобы записать результат в лог, сервер всё равно должен проверить запрос по регулярному выражению. Именно эта проверка и съела все доступные ресурсы.
Почему регулярка оказалась такой тяжёлой
Внутри выражения находилась конструкция, которую можно упростить примерно до .*.*=.*. Первый фрагмент .* означает «любое количество любых символов». Следующий говорит практически то же самое.
Движок регулярных выражений пытался определить, какая часть строки относится к первому фрагменту, а какая — ко второму. Если очередной вариант не подходил, он возвращался назад и пробовал другое разделение. Это называется backtracking.
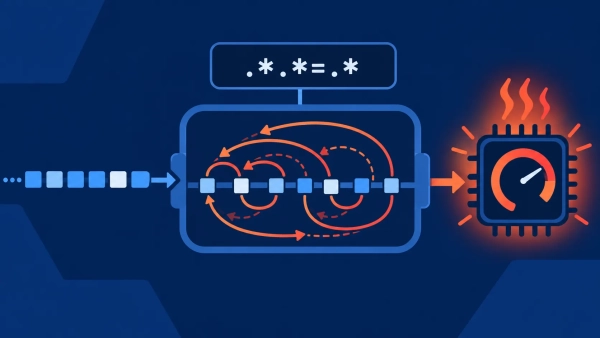
На короткой строке лишняя работа почти незаметна. Но с ростом входных данных количество попыток быстро увеличивается. Один запрос заставляет процессор перебирать множество вариантов, затем приходит следующий запрос, ещё один — и сервер перестаёт заниматься чем-либо, кроме неудачного поиска совпадений.
Такой класс проблем иногда называют ReDoS — отказом в обслуживании через регулярное выражение. В случае Cloudflare даже не потребовался специально подготовленный злоумышленник. Обычного мирового трафика оказалось достаточно.
Как ошибка за секунды стала глобальной?
Cloudflare умеет очень быстро распространять конфигурацию. Изменения правил доходили до серверов более чем в 180 городах примерно за несколько секунд. Обычно это серьёзное преимущество: новую уязвимость можно закрыть почти моментально.
В тот день скорость сработала против компании. Проблемное правило развернули сразу по всей сети, без постепенного запуска на небольшой группе серверов. Через три минуты после начала публикации уже стали поступать первые сигналы о сбоях.
В 13:42 по UTC началось развёртывание. В 14:09, после глобального отключения управляемых правил WAF, трафик вернулся к нормальному уровню. Основная недоступность продолжалась около 27 минут, хотя полное восстановление файрвола заняло больше времени.
Но ведь были тесты и код-ревью
Самая полезная часть этой истории находится именно здесь. Изменение прошло обычный рабочий процесс: pull request проверили и одобрили, CI собрал проект, автоматические тесты завершились успешно.
Тесты проверяли, находит ли WAF атаки и не блокирует ли нормальные запросы. Они отвечали на вопрос: «Правильно ли работает правило?» Но никто не проверял другой вопрос: «Сколько процессорного времени оно потребляет?»
Дополнительная защита от слишком долгого выполнения регулярных выражений ранее была случайно удалена во время рефакторинга. Сам движок не гарантировал предсказуемое время работы, а процедура развёртывания разрешала отправить обычное обновление WAF сразу на всю сеть.
Одна плохая регулярка стала спусковым крючком. Настоящую аварию устроила цепочка решений, каждое из которых по отдельности выглядело терпимо.
Почему откат тоже оказался сложнее ожидаемого
Сбой задел и внутренние инструменты Cloudflare. Компания использовала собственную инфраструктуру для доступа к панели управления, системе сборки и другим сервисам. Когда сеть легла, инженерам стало сложнее попасть в инструменты, необходимые для её восстановления.
Аварийный обход существовал, но применялся редко. Некоторым сотрудникам дополнительно мешали истёкшие права доступа. Получилась знакомая неприятность: запасной выход есть на схеме, однако в момент пожара не все знают, как быстро открыть дверь.
После инцидента Cloudflare добавила замеры производительности правил, вернула ограничение чрезмерного потребления CPU и перешла к поэтапному развёртыванию. Компания также решила использовать движки регулярных выражений с гарантированным временем выполнения.
Чему эта история учит разработчиков?
Регулярка может быть короткой и при этом вести себя как тяжёлый алгоритм. Поэтому её недостаточно проверить на нескольких удобных строках. Нужны длинные данные, случаи без совпадения и замер времени выполнения.
Но главный урок даже не в синтаксисе. Любое изменение, способное повлиять на весь трафик, следует выпускать постепенно: один сервер, небольшой процент запросов, отдельный регион — и только затем вся инфраструктура. При аномальном росте CPU развёртывание должно останавливаться автоматически.
Оцените материал: