Какая модель ИИ лучше всего подходит для графического дизайна, видеорекламы, синхронизации губ и многого другого? Новая платформа OpenArt Arena предлагает таблицы лидеров для различных задач в области медиа.
Карл Франзен
Компания OpenArt, четырехлетний стартап из Сан-Франциско, занимающийся разработкой креативных инструментов на основе ИИ и основанный бывшими сотрудниками Google Коко Мао и Джоном Цяо, стремится ответить на все более актуальный вопрос для предприятий и частных лиц, использующих модели ИИ для создания мультимедийного контента: не просто «какая модель лучше всего подходит?», а «какая модель лучше всего подходит для конкретной задачи, которую мне необходимо выполнить в области медиаконтента ?»
Именно поэтому сегодня компания запускает новый публичный бенчмарк для генерации изображений и видео с помощью ИИ: совершенно новая платформа OpenArt Arena разделяет рейтинги моделей на доски с примерами использования для таких областей, как кинопроизводство, электронная коммерция, графический дизайн, моушн-дизайн, видеомонтаж и синхронизация губ, используя слепые парные оценки от творческих специалистов и более широкого круга так называемых «законодателей вкуса».
Компания заявляет, что опубликует свою методологию и часть набора вопросов при запуске, при этом некоторые активные вопросы для оценки останутся закрытыми, чтобы снизить риск того, что модели будут настроены под эталонный показатель.
Идея проста, но становится все более необходимой. Модели генерации изображений и видео теперь разрабатываются достаточно быстро, поэтому творческая группа может потратить значительное время на то, чтобы просто решить, использовать ли серию GPT Image от OpenAI, семейство Nano Banana от Google, модели Seedream и Seedance от ByteDance, Wan от Alibaba, Grok Imagine от xAI или другой вариант.
«Наша цель — сделать это новым стандартом, чтобы все больше и больше людей узнали и признали его», — заявила Стелла Гуан, руководитель отдела развития и операций OpenArt AI, в эксклюзивном интервью VentureBeat, проведенном до завершения финального голосования в рамках Arena. «Когда творческие люди хотят выбрать лучшую модель изображения или видео, они вспоминают об OpenArt Arena и знают, что это наиболее авторитетный отраслевой стандарт для выбора модели».
Сама платформа OpenArt построена на основе этого изобилия: она позволяет пользователям работать с основными моделями изображений и видео от сторонних производителей, а также продает собственные продукты для создания контента более высокого уровня, включая Director — интерактивный рабочий процесс «режиссуры атмосферы» для создания многосценовых видеороликов.
В текущий каталог моделей OpenArt входят системы обработки изображений, видео, аудио и 3D-моделей от различных поставщиков.
«Какую модель мне следует выбрать?» — это один из вопросов, которые OpenArt неоднократно получает от корпоративных клиентов, сказал Гуан.
По словам эксперта, для компаний, пришедших из традиционных отраслей и только сейчас внедряющих генеративный ИИ, выбор модели может стать «первой проблемой при внедрении ИИ».
Но как создатели видеоконтента и художники, использующие ИИ, выбирают лучшую модель в настоящее время?
Один из плодовитых создателей контента, работающий под псевдонимом @BLVCKL!GHT, рассказал VentureBeat в личном сообщении: «Выбор модели полностью зависит от требуемой работы. Зацикленные анимации и более динамичные сцены требуют других инструментов, поэтому в зависимости от этого проект может остановиться на Minimax или Seedance 2.5. Клиенты часто запрашивают самые современные модели, что и определяет мой выбор, но в конечном итоге бюджет определяет, что практично для конкретного проекта».
Организовано вокруг конкретных творческих вакансий в сфере медиа с использованием искусственного интеллекта.
Вместо того чтобы публиковать одну оценку для изображений и одну для видео, OpenArt создает отдельные доски, посвященные вакансиям и творческим дисциплинам.
Это включает в себя отдельные таблицы лидеров, показывающие, как модели обработки изображений и видео, созданные с помощью ИИ, оцениваются (по мнению отобранных вручную профессиональных пользователей OpenArt и сторонних экспертов, число которых превышает 800) при выполнении задач в области анимации, рекламы, графического дизайна, электронной коммерции, кинопроизводства, моушн-дизайна, видеомонтажа, синхронизации губ и в целом.
Предполагается, что каждая рекламная кампания должна использовать критерии, адаптированные к конкретной работе. Гуань привел в качестве примера кинопроизводство: там большее значение могут иметь движение камеры, освещение, кинематографическое качество и реалистичность кожи, в то время как в рекламном процессе большее значение могут придаваться читаемому тексту, точным логотипам, качеству изображения продукта и размещению.
Такой подход имеет значение, потому что модель, которая сильна в одной конкретной творческой задаче, не обязательно является лучшей в другой.
Для бизнеса это различие имеет гораздо большее значение, чем может показаться на первый взгляд. Отдел маркетинга, создающий изображения для упаковки, внутренняя студия, занимающаяся предварительной визуализацией рекламного ролика, и команда постпродакшена, редактирующая существующие видеоматериалы, могут называть себя «использующими видео с помощью ИИ», предъявляя при этом совершенно разные требования к базовой модели.
Таблица лидеров, объединяющая эти задачи в один показатель предпочтений, может быть полезна для поиска систем с широкими возможностями, но при этом мало что может подсказать команде предприятия, какую модель следует использовать для выполнения конкретной производственной задачи.
Компания OpenArt заявляет, что генерирует результаты на основе тщательно подобранных наборов подсказок для каждой доски и представляет их оценщикам без указания меток модели.
Судьи делают выбор, сравнивая работы между собой, а не выставляя отдельные оценки, и OpenArt объединяет эти предпочтения, используя статистическую модель Брэдли-Терри 1952 года — уравнение, которое вычисляет скрытую вероятность победы работы на основе ее результатов в сравнении с конкурентами.
В состав жюри входят два уровня. В меньший по численности Совет экспертов по креативу входят известные специалисты, такие как лауреат премии «Эмми» за анимацию Уильям Лау, креативный технолог Вилониус «Кинг Вилониус» Хэтчер, лидер в области маркетинга Дэвид Шинг, а также руководители и преподаватели из таких организаций, как Edelman и UCLA.
Гуан сказал, что OpenArt также набирает примерно от 800 до 1000 «лидеров мнений» из числа пользователей OpenArt, представителей нетворческих сообществ и работающих профессионалов в таких областях, как реклама.
Это число следует понимать как запланированное количество участников, а не как подтвержденное число людей, завершивших оценку запуска. OpenArt не предоставила окончательное число судей, принявших участие в голосовании, общее количество парных оценок или количество заданий в каждом критерии оценки запуска в материалах, рассмотренных для этой статьи.
Гуань сказала, что компания намерена опубликовать часть каждого набора подсказок и может выпустить более старые подсказки после будущих обновлений, но не весь активный набор. «Одна из причин, по которой мы не публикуем все сразу при запуске, заключается в том, что это было бы легко адаптировать под эти наборы данных», — сказала она.
Это вполне обоснованное опасение, связанное с проектированием эталонных тестов: полностью открытый статический тест в конечном итоге может измерить, насколько эффективно разработчики моделей оптимизируют свои решения, опираясь на сам тест, а не насколько хорошо их системы обобщаются на неизвестные ранее творческие работы.
Однако сокрытие тестовых материалов создает соответствующую нагрузку на прозрачность. Пользователи должны доверять тому, что нераскрытые вопросы адекватно отражают профессию и что результаты моделирования генерируются, отбираются и сравниваются последовательно.
Что показывают первые результаты рейтинга OpenArt Arena
Результаты видеоанализа дают наиболее четкое представление о рейтинге OpenArt Arena на момент запуска.
Модель Seedance 2.5 от ByteDance, представляющая собой собственную API-ориентированную систему, для которой ByteDance не опубликовала общедоступные весовые коэффициенты, лидирует в общем рейтинге видеоплатформ с результатом 1081 балл, за ней следует Wan 3.0 от Alibaba с 1004 баллами и Seedance 2.0 от ByteDance с аналогичным закрытым весом — 1000 баллов.
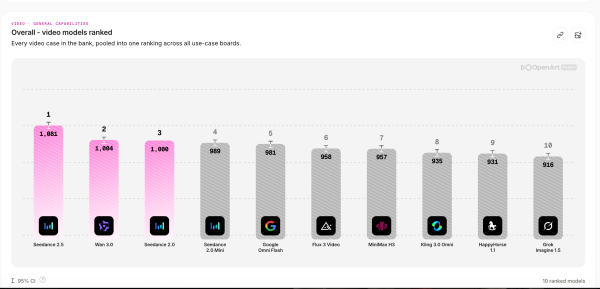
WAN 3.0 является исключением в плане открытости: Alibaba описывает его как проект с открытым исходным кодом и опубликовала репозиторий с лицензией Apache 2.0, хотя в настоящее время этот репозиторий содержит документацию и информацию о лицензировании, а не загружаемые веса моделей, поэтому его пока не следует рассматривать как обычный релиз с открытым исходным кодом, который можно разместить на собственном сервере.
Преимущество Seedance 2.5 сохраняется в большинстве более специализированных категорий видео, оцененных OpenArt: из пяти предоставленных для запуска рейтингов видео он занимает первое место в четырех и второе в пятом. В рейтинге фильмов Seedance 2.5 занимает первое место с 1049 баллами, опережая Seedance 2.0 с 1000 баллами и Wan 3.0 с 958 баллами. Он также лидирует в категории моушн-дизайна с 1059 баллами, за ним следуют Seedance 2.0 с 1000 баллами и Wan 3.0 с 990 баллами.
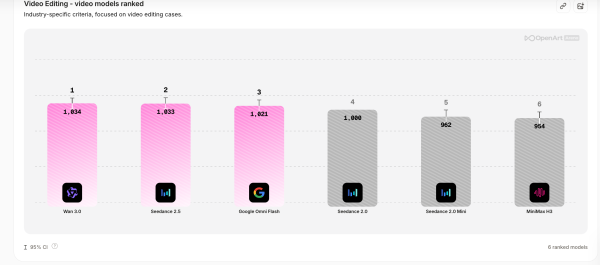
Редактирование видео является исключением (хотя и незначительным) — и одним из наиболее полезных результатов для иллюстрации аргумента OpenArt о том, что выбор модели должен зависеть от задачи.
WAN 3.0 занимает первое место с 1034 точками подключения, за ним следует Seedance 2.5 с 1033 точками, а проприетарная технология Google Gemini Omni Flash — третье место с 1021 точкой.
Google распространяет Omni Flash как часть семейства моделей Gemini, а не в виде загружаемых открытых весов. Затем Seedance 2.5 снова выходит на первое место по синхронизации губ, набрав 1063 балла, опередив Seedance 2.0 с 1000 баллами и Seedance 2.0 Mini, еще один вариант, размещенный на ByteDance, а не выпущенный в виде открытых весов, с 994 баллами.
Другими словами, Seedance 2.5, судя по результатам тестирования OpenArt на старте, демонстрирует наилучшие общие показатели для обработки видео, но формально он не выигрывает во всех специализированных задачах.
OpenArt отображает 95%-ные доверительные интервалы на панелях, что является важным критерием при близких результатах. Разница в один балл, например, 1034 у Wan 3.0 против 1033 у Seedance 2.5 в видеомонтаже, сама по себе не должна рассматриваться как свидетельство существенного разрыва в качестве.
Доминирование Seedance 2.5 отражается в его широком использовании в сфере создания контента с помощью ИИ. Зак Лондон, более известный как создатель высококачественных научно-фантастических/фэнтезийных видеороликов с использованием ИИ, Gossip Goblin, чей полнометражный фильм об ИИ под названием «Боги не дарят подарки» выйдет в прокат в сотнях кинотеатров в конце этого года , сообщил VentureBeat в личном сообщении на X:
«Год назад рынок был довольно разнообразным — Hailuo, Kling и Veo имели свои преимущества, наряду с более нишевыми инструментами для синхронизации губ, такими как Sync Labs, Hedra и HeyGen. Теперь Seedance настолько опережает все остальное, что это даже не обсуждается. Я могу с уверенностью сказать, что ни один из уважаемых создателей контента в этой сфере больше не использует ничего, кроме Seedance. H3 от Hailuo используется для массовой рассылки спама и автоматизации, но для серьезной работы единственным вариантом остается Seedance».
Для корпоративных покупателей более полезным сигналом является общая закономерность: какие модели неизменно демонстрируют высокие результаты, где изменение производственной задачи меняет порядок выполнения, и может ли модель быть размещена на собственном сервере или же требует зависимости от поставщика или API-провайдера.
Рейтинги изображений более фрагментированы, и ни одна модель не занимает лидирующие позиции среди всех трех стартовых платформ, предоставленных для этой статьи.
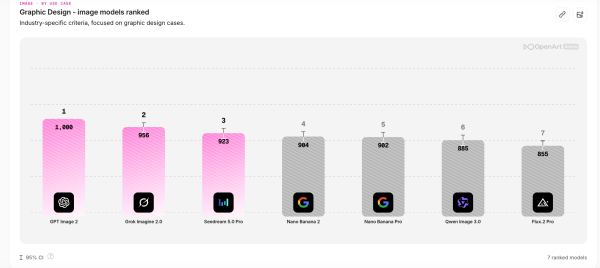
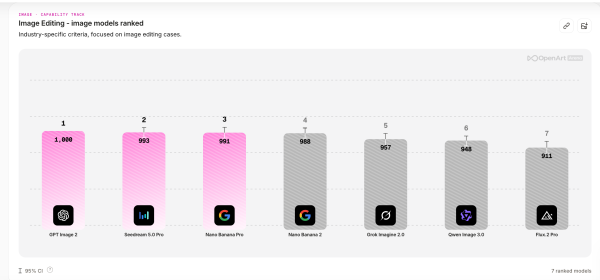
Собственная модель GPT Image 2 от OpenAI, доступная через API OpenAI, а не в виде модели с открытыми весами, занимает первое место в графическом дизайне и редактировании изображений, в обоих случаях занимая 1000-е место.
Тем не менее, что касается изображений, ориентированных на пленочную фотографию, Seedream 5.0 Pro лидирует с результатом 1014 баллов, в то время как закрытые форматы Nano Banana Pro (Gemini 3 Pro Image) и GPT Image 2 от Google набирают по 1000 баллов, занимая второе и третье места соответственно. Seedream 5.0 Pro также лидирует в категории изображений для электронной коммерции с результатом 1004 балла, немного опережая GPT Image 2 (1000 баллов) и аналогичный фирменный формат Nano Banana 2 (Gemini 3.1 Flash Image) от Google (993 балла).
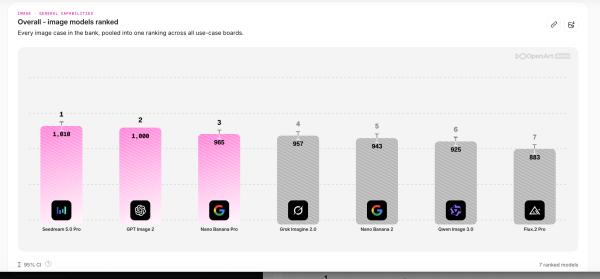
В целом, что касается производительности моделей обработки изображений во всех задачах, эксперты OpenArt отдали предпочтение Seedream 5.0 Pro от Alibaba с результатом 1010 баллов, опередив GPT Image 2 на 10 баллов. Следует отметить, что на прошлой неделе OpenAI обновила модель до GPT-Images-2.5, поэтому таблицу лидеров OpenArt также необходимо будет обновить с учетом этого изменения.
Таким образом, разница в степени открытости довольно заметна среди лидеров запуска OpenArt: Wan 3.0 — единственный заметный участник первой тройки, представленный своим разработчиком как проект с открытым исходным кодом, хотя его текущий публичный релиз, похоже, пока не обеспечивает необходимых условий для независимого самостоятельного размещения.
Для предприятий это не просто вопрос лицензирования: это влияет на контроль развертывания, размещение данных, возможности настройки, зависимость от поставщика и потенциально на общую стоимость владения.
Выступая до публикации окончательных результатов, Гуань заявила, что предварительное голосование OpenArt уже выявило неожиданные случаи. «Есть определенные области, которые нас удивили», — сказала она. «Некоторые модели, которые, как мы думали, не займут высоких позиций в конкретном случае использования, — их преимущества еще более ярко проявились в этом рейтинге».
По ее словам, в этом и заключается смысл разделения задач. «Если конкурировать только в целом, некоторые модели могут оказаться не лучшими, — сказала Гуань. — Но они могут быть лучшими в конкретных сценариях использования или по конкретным критериям».
Итоговые результаты, по крайней мере, подтверждают это предположение, даже если они не переворачивают рынок в целом. В тестах OpenArt Seedance 2.5 выглядит скорее сильным универсальным инструментом для видеомонтажа, чем узкоспециализированным разработчиком, но первое место Вана в видеомонтаже и меняющийся список победителей в категории обработки изображений демонстрируют, почему командам разработчиков по-прежнему может быть целесообразно распределять задачи между несколькими моделями, вместо того чтобы слепо стандартизироваться на одной.
OpenArt — не первая и не единственная платформа, предлагающая рейтинги по категориям.
|
Таблица лидеров / бенчмарк |
Кто судит? |
Как сегментируются рейтинги |
Подход к оценке |
Ключевое отличие |
|
Открытая Арт-Арена |
Совет экспертов в области креатива + расширенный круг креативных «законодателей вкуса» |
Конкретные творческие профессии: кинопроизводство, графический дизайн, электронная коммерция, моушн-дизайн, видеомонтаж, синхронизация губ и т. д. |
Подборка заданий, специально разработанных для конкретных задач; попарное сравнение вслепую; рейтинги Брэдли-Терри. |
Наиболее четко структурирована вокруг отдельных производственных задач как в области изображений, так и видео; интегрирована с коммерческой креативной платформой. |
|
Contra Labs — Критерий оценки человеческого творчества |
Профессиональные специалисты творческих профессий, набранные из сети Contra. |
Креативные области + этапы рабочего процесса: целевые страницы, изображения для рекламы, фирменные изображения, видеоролик о продукте и т. д., каждый этап тестируется на стадиях разработки идеи, создания макета и доработки. |
Слепые попарные сравнения + скалярные оценки + качественная обратная связь; Брэдли-Терри/Эло; публикует подробную методологию исследования и наборы данных. |
Это скорее постоянно действующая исследовательская программа, чем просто рейтинговая таблица; анализируются причины изменения результатов на разных этапах и точки, где мнения экспертов сходятся или расходятся. |
|
Arena.ai |
Масштабное общественное/общественное голосование |
Изображения: коммерческий дизайн, кинематографические образы, портреты, визуализация текста, 3D, искусство и т. д. Видео сегментировано в большей степени по поколениям. |
Слепое попарное определение предпочтений с ранжированием по категориям, полученным на основе миллионов реальных запросов; сообщается о неопределенности/разбросе рангов. |
Основной упор делается на масштабные действия пользователей и органичные запросы, а рейтинг изображений уже в значительной степени совпадает с концепцией OpenArt, ориентированной на решение конкретных задач. |
|
Искусственный анализ |
Групповое голосование с учетом слепых предпочтений |
Примеры использования изображений: маркетинг, электронная коммерция, художественные фильмы, UI/UX и контент для создателей контента. Видео же имеет более специфическую функциональную область, включающую преобразование текста в видео, изображения в видео, редактирование и различные варианты аудио. |
Подборка ключевых слов; слепое попарное голосование; алгоритм Брэдли-Терри Эло; также отслеживает цену, скорость и статус открытого веса. |
Наиболее широкий подход к сравнительному анализу и закупкам, сочетающий качество со стоимостью, задержкой и открытостью модели; категории изображений в значительной степени специфичны для конкретной задачи, в то время как сегментация видео в большей степени основана на модальностях, чем доски объявлений OpenArt для творческих задач. |
Однако OpenArt — далеко не единственная компания, предлагающая рейтинги производительности моделей ИИ в творческих задачах.
Например, компания Contra Labs уже проводит оценку генеративных моделей креатива на практике в рамках своей программы Human Creativity Benchmark (HCB), которую она представила в апреле 2026 года как способ для творческих специалистов оценивать системы ИИ на примере профессиональной творческой работы.
Вместо того чтобы полагаться на общие технические показатели, Contra привлекает работающих креативщиков из своей сети, предоставляет моделям реальные задания, скрывает личности моделей во время оценки и использует попарные сравнения, агрегированные с помощью модели Брэдли-Терри, для составления рейтингов в стиле Эло (шахматная система).
Более широкая структура HCB от Contra Labs охватывает такие области, как целевые страницы, настольные приложения, рекламные изображения, фирменные изображения и видеоролики о продуктах, и разбивает работу на этапы генерации идей, создания макетов и доработки — структура рабочего процесса, которая отличается от более детальной оценки конкретных творческих задач в OpenArt Arena, таких как создание фильмов, моушн-дизайн, видеомонтаж и синхронизация губ.
Система оценки Contra также призвана учитывать не только предпочтения победителей и проигравших. Эксперты оценивают результаты по таким параметрам, как оперативность выполнения, удобство использования и визуальная привлекательность, и предоставляют качественные объяснения своих суждений. Contra четко различает «конвергенцию», когда профессионалы, как правило, соглашаются по таким вопросам, как читаемость или техническая корректность, и «дивергенцию», когда разногласия отражают законные различия во вкусе и творческом направлении. Исследования компании неоднократно показывали, что ни одна модель не доминирует на каждом этапе творческой работы — вывод, который тесно перекликается с аргументом OpenArt о том, что «лучшая» модель зависит от конкретной задачи.
Помимо основной деятельности HCB, Contra Labs проводит постоянную исследовательскую программу, включающую состязания моделей, составление профилей и полевые заметки по таким направлениям, как создание изображений, видео, веб-дизайн, типографика, разработка логотипов, перенос стиля и другие профессиональные творческие задачи.
В последних исследованиях вновь рассматривались те же области по мере появления новых моделей или изменения структуры оценки компанией Contra, и компания публикует данные о количестве оценщиков, структуре вопросов, объемах вынесенных решений и, в некоторых случаях, открытые наборы данных наряду со своими выводами.
Это делает Contra одним из наиболее очевидных существующих конкурентов OpenArt Arena. Ключевое отличие заключается не столько в методологии, сколько в том, как продукты организованы и представлены.
В настоящее время Contra работает скорее как постоянно обновляемая программа исследований и сравнительного анализа, часто анализируя, где и почему производительность модели меняется на разных этапах рабочего процесса.
OpenArt запускает Arena как постоянно доступный публичный слой для отбора моделей, с отдельными таблицами лидеров для конкретных задач, связанных с изображениями и видео, таких как кинопроизводство, электронная коммерция, моушн-дизайн, видеомонтаж и синхронизация губ. Другими словами, оценка профессионалов, слепое сравнение и оценка с учетом рабочего процесса не являются уникальными для OpenArt; его отличие заключается скорее в том, что он объединяет эти идеи в широкий, постоянно доступный набор таблиц лидеров для конкретных задач, которые также могут отображаться внутри собственной творческой платформы.
Arena.ai также уже предлагает рейтинги изображений по категориям. Компания представила рейтинги категорий после анализа большого количества реальных запросов на создание изображений, разделив их на области, включая дизайн продукции, брендинг и коммерческий дизайн; фотореалистичные и кинематографические изображения; портреты; рендеринг текста; 3D-визуализация и моделирование; искусство; и другие области. Arena.ai заявляет, что рейтинг категории использует ту же базовую методологию оценки, что и вся платформа Arena, но с фильтрацией по запросам, относящимся к данной области.
Масштаб этого подхода значительно превосходит уровень экспертных оценок. Только на доске Arena.ai для преобразования текста в изображения в рамках разделов «Продукт, брендинг и коммерческий дизайн», созданной 7 сентября, зарегистрировано более 1,9 миллиона голосов по 78 моделям. Аналогичным образом, на платформе для редактирования изображений предлагаются категории для коммерческого дизайна, кинематографических изображений, портретов, рендеринга текста и других задач.
Как сообщил VentureBeat в личном сообщении на X другой плодовитый создатель видеоконтента с использованием ИИ, Кири Маргарос (@Kyrannio), создатель автоматизированной студии видеопроизводства No Spoon Studios:
«Обычно я использую Arena для оценки существующих решений, и, особенно в отношении текста, изображений или видео, уделяю больше внимания метрикам и моделям в своих продуктах, когда они показывают высокие результаты в тестах и дебютируют на разных платформах. Если же я не использую рейтинги, то в итоге просто внедряю новые модели в свой продукт по мере их появления и оцениваю их эффективность в рамках моей текущей инфраструктуры. Думаю, что стоимость и скорость также являются компромиссом, как и чрезмерно агрессивная модерация. Если у вас очень медленная модель, которая работает бесконечно, стоит дорого и модерирует всё, что вы делаете, позиции в рейтинге не так важны, потому что она становится практически непригодной для использования. Хотя в целом это отличный и быстрый способ быстро определить, какие модели будут самыми передовыми и какими будут их сильные стороны, прежде чем полностью внедрять их через API, если это вообще возможно! … Многие метрики Arena для новых моделей действительно помогают мне в разработке продуктов, и я уделяю Arena наибольшее внимание именно в этом аспекте».
Таким образом, утверждение «профессионалы оценивают результаты» не ново, как и утверждение «в разных категориях разные рейтинговые таблицы».
Существенное отличие OpenArt заключается в сочетании и организации этих идей. Категории изображений в Arena.ai в основном представляют собой кластеры по темам запросов, сформированные на основе масштабного использования сообществом, а это значит, что специализированные рейтинги изображений формируются путем фильтрации голосов из запросов, отнесенных к этим темам.
OpenArt начинает с противоположного подхода: сначала определяется профессиональный сценарий использования , разрабатывается специальный набор тестов и критерии для этой платы, а затем выбранная группа экспертов оценивает результаты на их основе.
Анализ с помощью Artificial Analysis — еще один пример, который очень близок к OpenArt, и в плане обработки изображений он еще больше сужает круг его отличий. Его Image Arena не ограничивается одним общим рейтингом преобразования текста в изображение: Artificial Analysis утверждает, что оценивает модели по таксономии реальных сценариев использования, включая маркетинг и рекламу, розничную торговлю и электронную коммерцию, кинопроизводство, анимацию и игры, архитектуру и недвижимость, UI/UX дизайн, социальные сети и контент для создателей контента и другие, а также по специфическим параметрам, таким как рендеринг текста, верстка и анатомия человека.
Он публикует соответствующие подкатегории изображений, включая «Коммерческая реклама», «Люди/Портреты» и «Текст и типографика», и использует тщательно подобранные подсказки, помеченные как вариантами использования, так и возможностями. Результаты оцениваются путем слепого попарного голосования пользователей, а рейтинги рассчитываются с использованием метода максимального правдоподобия Брэдли-Терри, при этом набор подсказок обновляется ежемесячно. Это означает, что доски изображений OpenArt для фильмов и электронной коммерции сами по себе не являются новым видом ранжирования изображений, ориентированного на конкретную задачу.
В видеоформате это различие более значимо. Компания Artificial Analysis поддерживает отдельные пулы Video Arena Elo для преобразования текста в видео, изображений в видео и видеомонтажа, с дополнительным разделением для моделей, генерирующих синхронизированный звук, и публикует фильтры по цене и весу открытия вместе с рейтингами.
Однако это в основном разделения по способу генерации или техническому рабочему процессу, а не по более детальным профессиональным инструментам, которые OpenArt запускает для кино, моушн-дизайна, видеомонтажа и синхронизации губ. Таким образом, Artificial Analysis уже в значительной степени пересекается с OpenArt в бенчмаркинге задач обработки изображений и даже напрямую конкурирует в видеомонтаже, в то время как более сильное отличие OpenArt, по-видимому, заключается в широте его рейтингов видео, ориентированных на конкретные творческие задачи, и использовании отобранного экспертного совета и пула творческих специалистов/законодателей моды, а не в более широком краудсорсинговом голосовании предпочтений, характерном для Artificial Analysis.
Компания Artificial Analysis также открыто заявляет о своей независимости и утверждает, что не принимает никакого вознаграждения от поставщиков моделей за включение в рейтинг или за положительные результаты — это структурное отличие от OpenArt, которая управляет коммерческой творческой платформой, где многие из моделей, занимающих высокие места в рейтинге, доступны пользователям.
Для руководителя креативного направления в крупной компании эти методологические различия могут изменить подход к использованию рейтинга. Широкий рейтинг предпочтений сообщества может помочь выявить модели, пользующиеся всеобщей популярностью, в то время как узкоспециализированный профессиональный бенчмарк может быть более полезен для маршрутизации рабочего процесса.
Ни один из этих методов не заменяет внутреннее тестирование собственных брендов компании, их характеристик, правовых ограничений и производственных стандартов. Поэтому практическая ценность Arena будет зависеть как от того, насколько точно OpenArt определит каждую доску, так и от того, какая модель займет первое место.
Иными словами, обоснованное отличие OpenArt заключается не в том, что компания изобрела экспертную оценку или сегментацию по категориям. Она пытается объединить тщательно отобранные, специфичные для каждой профессии тестовые наборы, экспертное судейство, более широкий круг оценщиков и постоянно доступную таблицу лидеров по изображениям и видео в одном месте.
Это также напрямую связывает этот бенчмарк с выбором модели внутри коммерческой креативной платформы. Это может сделать Arena необычайно полезной для пользователей, которые могут переходить от ранжирования к генерации контента с помощью ранжированной модели в одной и той же среде, но это также поднимает важнейший вопрос управления, связанный с запуском.
Вопрос независимости
Есть еще одно отличие, которое следует учитывать корпоративным покупателям: OpenArt — это не независимая академическая организация, занимающаяся бенчмаркингом. Это коммерческая платформа для создания контента с использованием ИИ, работающая на том же рынке, который оценивает ее рейтинг.
Сама компания OpenArt заявляет, что объединяет более 100 моделей, а в её текущий каталог моделей входят такие системы, как Seedance, Veo, Kling, Wan, GPT Image, Nano Banana, Seedream и Grok Imagine.
Это не означает, что результаты запуска предвзяты, и представленные рейтинги, по всей видимости, не включают в себя изображение или видеомодель, созданные на основе бренда OpenArt.
Однако OpenArt продает доступ ко многим сравниваемым моделям и использует их в своих продуктах, таких как Director. Ее видеопродукт явно предлагает пользователям ряд базовых моделей в рамках одного рабочего пространства.
По словам Гуана, Arena также будет отображаться в собственном интерфейсе выбора моделей OpenArt, так что этот эталонный показатель сможет влиять на выбор базовой модели клиентом, оставаясь при этом в рамках платформы OpenArt.
Это делает взаимоотношения более сложными, чем при использовании обычных сторонних эталонных моделей. У OpenArt есть веские причины помогать пользователям делать правильный выбор — клиент, получивший плохие результаты с неправильной моделью, может винить платформу, — но у компании также есть коммерческий интерес в том, чтобы стать местом, где клиенты принимают это решение и реализуют его.
Правильный вывод заключается не в том, что результаты Arena следует игнорировать, а в том, что ее методология и управление заслуживают такого же тщательного анализа, который предприятия применяют к любому сравнительному анализу, разработанному поставщиком и способному повлиять на решения о закупках или маршрутизации рабочих нагрузок.
Это делает управление и воспроизводимость более важными, а не менее важными. К моменту запуска OpenArt раскрыла статистический подход, общую стратегию привлечения участников, назвала членов своего экспертного совета и планирует опубликовать несколько заданий. Однако компания пока не предоставила данные о количестве заданий, количестве завершенных судей или общем количестве голосов, которые позволили бы сторонним лицам сравнить масштаб и охват оценок запуска с опубликованными исследованиями Contra или обширными массивами данных голосования сообщества Arena.ai.
Сравнение делает это упущение еще более заметным, поскольку конкуренты показали, что эти цифры можно раскрыть, не обязательно публикуя весь сравнительный анализ. Contra, например, публикует количество оценщиков, структуру задачи и общее количество парных оценок, при этом продолжая проводить повторные исследования. Arena.ai же публикует количество голосов и диапазоны достоверности непосредственно рядом со своими рейтингами.
Планируемая OpenArt группа экспертов, состоящая из 800-1000 человек, звучит внушительно, но пока OpenArt не сообщит, сколько человек фактически участвовало в той или иной оценке, сколько оценок они вынесли и сколько тем просмотрели, читатели не смогут понять, насколько достоверны данные, лежащие в основе индивидуальной оценки запуска.
Для крупных команд OpenArt Arena должен стать скорее инструментом выбора модели на основе входных данных, чем универсальным инструментом. Наиболее полезным эталоном является тот, который максимально приближен к реальной работе организации: фотографии продукции с точной упаковкой, рекламные материалы с типографикой, кинематографические эпизоды с движением камеры или монтаж, который должен сохранять существующие видеоматериалы клиента.
Специализированные панели OpenArt движутся в этом направлении, и компания также планирует включить более объективную информацию о моделях, ориентированных на корпоративный сектор, такую как ценообразование, модерация контента и характеристики защиты интеллектуальной собственности. Гуань сказал, что OpenArt также хочет показать компромисс между ценой и производительностью, а не ранжировать качество без учета бюджета.
Компания заявляет, что Arena будет публичной и «в некоторой степени независимой» от остальной части OpenArt, а Гуан сказал, что OpenArt в конечном итоге может изучить возможность партнерства, которое позволит другим платформам использовать или интегрировать рейтинги. Это не входит в первоначальный запуск.
Место OpenArt Arena в корпоративном рабочем процессе искусственного интеллекта
OpenArt Arena появляется в нужный момент, поскольку поиск креативного ИИ-решения становится сложной задачей. Модель, создающая лучшее главное изображение, может не совпадать с той, которая обеспечивает качественную отрисовку типографики; лучший генератор кинематографических изображений может не совпадать с лучшим редактором; а модель с наивысшим эстетическим потенциалом может оказаться нерентабельной в масштабе.
Первые результаты Arena наглядно демонстрируют этот аргумент. Seedance 2.5 стал лучшим среди видеоплатформ OpenArt на старте продаж, заняв первое место в общем зачете, а также в категориях «фильм», «моушн-дизайн» и «синхронизация губ», при этом уступив лидерство в категории «видеомонтаж» всего на один балл.
В сфере обработки изображений лидерство разделилось между GPT Image 2 для графического дизайна и Seedream 5.0 Pro для киноиндустрии и электронной коммерции.
Эти результаты более полезны в качестве карты, показывающей, где модели демонстрируют наибольшую эффективность, чем в качестве заявления об одном окончательном победителе — особенно на рынке, где, как отметил Гуан, следующая модель может появиться уже через неделю.
Результаты запуска подтверждают это. Более сложный вопрос теперь заключается в том, сможет ли OpenArt сделать сам бенчмарк достаточно прозрачным, чтобы творческие коллективы доверяли рекомендуемому им пути.
Источник: venturebeat.com
Оцените материал: