Xiaomi открыла модель, которая генерирует сложные звуковые сцены целиком Команда…

Xiaomi открыла модель, которая генерирует сложные звуковые сцены целиком
Команда MiLM Plus из Xiaomi выложила в открытый доступ MiDashengLM-Gen — генератор аудио по текстовому описанию. Он собирает не отдельный голос или трек, а полноценную звуковую сцену: речь, музыку, шумовые эффекты и фоновую акустику вместе.
Внутри — аудиотокенизатор MiDashengLM-0.6B, дообученная языковая модель Qwen3-1.7B и генеративная часть Flow Matching на базе DiT. Управление идёт через теги промпта: caption, asr, speech, sfx, music, env, а ненужные поля помечаются как unknown. На выходе — WAV 16 кГц длительностью до 20 секунд.
Обучали модель на приватном датасете ACAVCaps объёмом 77 тысяч часов плюс открытых наборах Emilia, LibriTTS, LJSpeech, AISHELL-3 и WenetSpeech4TTS. Русского в речевой части ACAVCaps всего 4,66% против 54% английского и 24,5% китайского — это сразу видно по качеству: доля ошибок на русском 13,19% против 2,42% на английском.
По метрикам на Seed-TTS ошибки снизились с 12,15% до 2,79%, на CV3-Eval эмоции распознаются уверенно: радость 0,98, грусть 0,96, злость 0,92. А вот на AudioCaps результат скромнее — FAD 5,01 против 2,26 у TangoFlux, то есть в чистой генерации звуковых эффектов конкуренты пока сильнее.
Похожие записи
Оцените материал:
Похожие записи
🎬 БЕСПЛАТНАЯ АЛЬТЕРНАТИВА CAPCUT: МОНТАЖ БЕЗ ОГРАНИЧЕНИЙ Представляем полностью бесплатный…
05.10.2026
Google научит вас собирать своих ИИ-агентов — вышел Advent of…
05.10.2026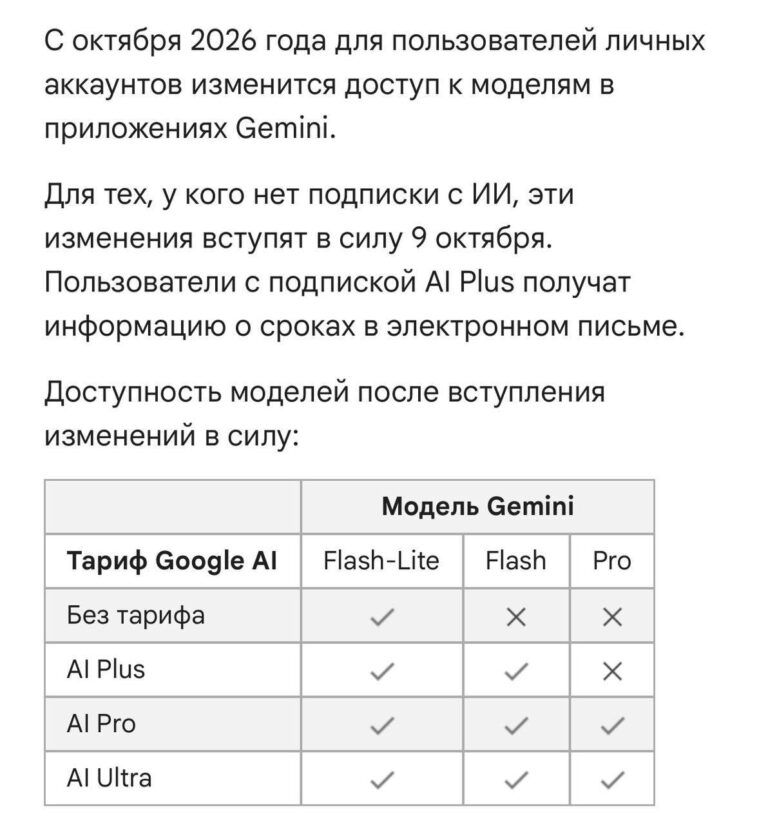
Google УРЕЗАЕТ бесплатный Gemini — с 9 октября пользователям оставят…
05.10.2026Присоединяйтесь и подпишитесь на рассылку самых свежих новостей по Email
Получайте свежие новости и идеи на почту. Без спама — только самое интересное.
Нажимая «Подписаться», вы соглашаетесь с политикой конфиденциальности.